
















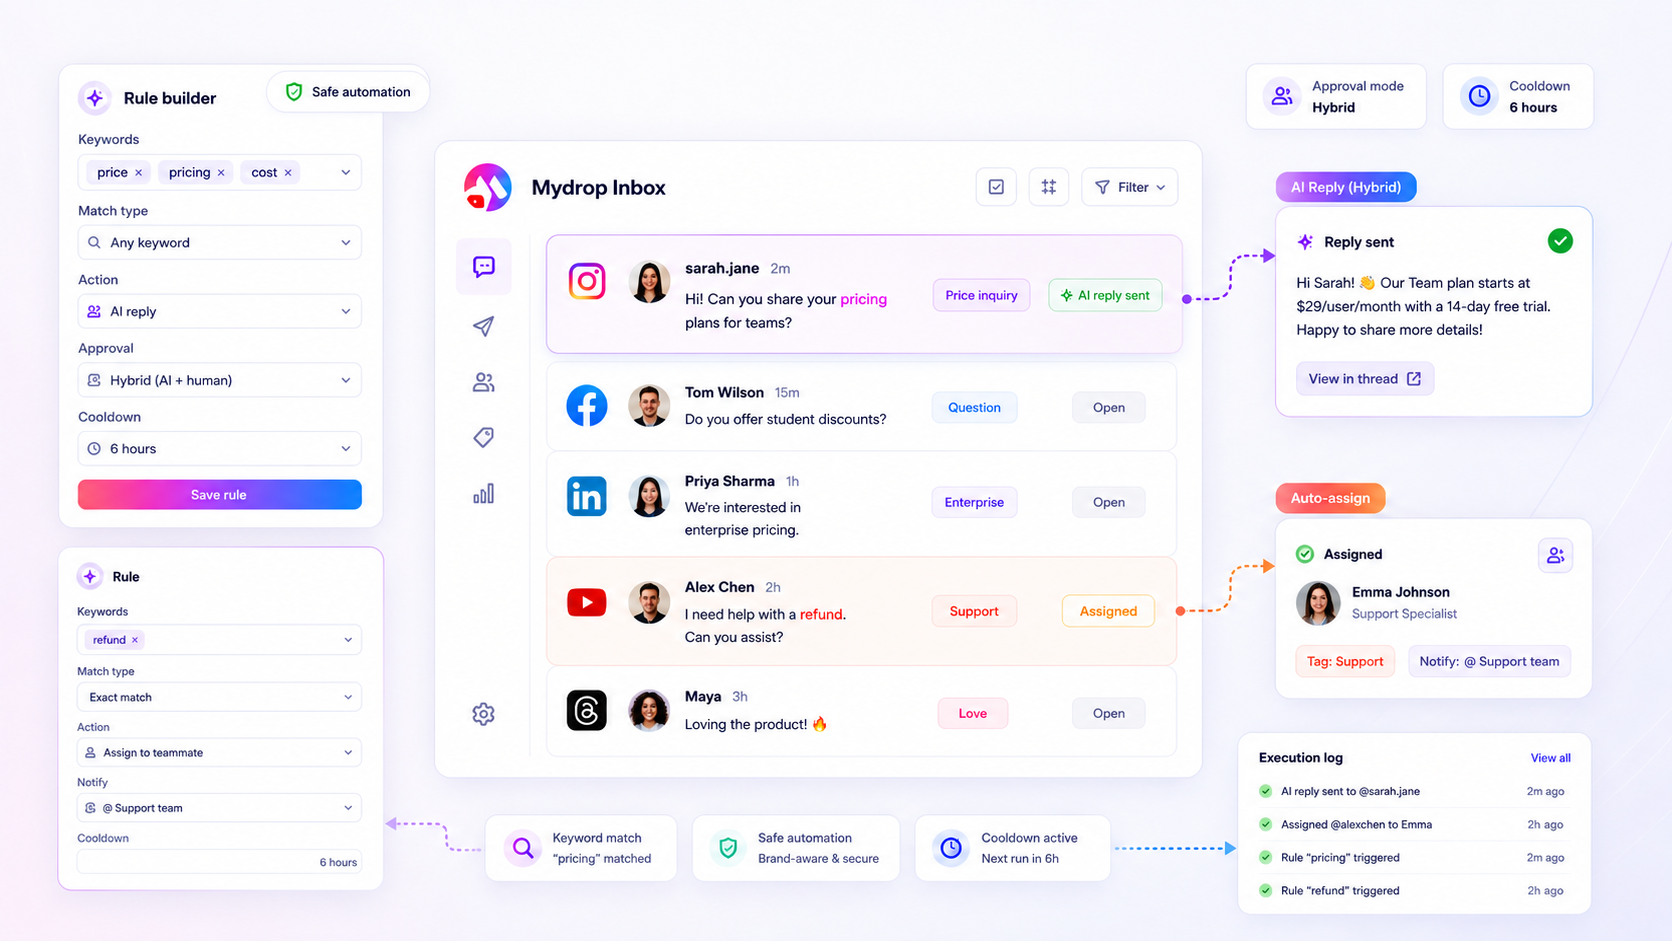
收件箱规则抓不到相关线索或客服请求时,你第一反应可能是怪平台 API 或者算法抽风。但真相是,90% 漏掉的消息,其实是被你自己的逻辑困住的:规则明明开着,却因为优先级互相打架、或者关键词定得太窄,实际上等于没干活。
这种场面我们太熟了。你花了好几个小时调教客服自动化,想给团队省点时间,结果那些本该被规则接住的消息,还得自己一条条手动分流。这种协调上的欠账,会把一个省时的工作流硬生生变成天天要审查的苦差事。好消息是,这基本不是算法的锅,多半只是配置该清理了。
数字变化之前,到底发生了什么
我们看过几百个品牌账号,最常见的元凶是逻辑叠加冲突。你为了抓一个热点问题,新加了一条很具体的规则,却没顺手审查原来那些范围很宽的规则,结果等于给自己造了一座数字迷宫。消息明明就在那儿,可你自己的自动守门员在打标签、发通知之前,就把它们拦下了。
在动手重写整个规则库之前,先捋一捋问题是什么时候开始的。是不是某次 AI 回复翻车之后,你加了个新筛选条件?是不是为了躲开某场高流量活动里的误报,你把关键词匹配收紧了?
大多数团队就卡在这儿:
- 规则撞车: 你有一条范围很宽的「通用客服」规则,用的是
contains_any关键词,又新加了一条「产品 X」规则,用的是contains_all。两条规则一重叠,执行顺序常常逼着更严的那条直接退出,更糟的是,如果对话已经打过标签,它干脆把动作整个取消。 - 精准陷阱: 你被无关噪音烦透了,于是把
contains_any换成了exact精确匹配。结果现在,一句简单的「Help!」,或者产品名里少了个空格,规则就直接把消息忽略了。 - 筛选条件臃肿: 你为了保护某个敏感账号,加了针对特定账号的排除条件,却一不小心把一个覆盖整个品牌矩阵的高优先级标签也锁在了门外。
操作守则: 规则不触发了,先看执行日志,别急着动关键词。如果日志显示规则是被跳过,而不是执行失败,那就是优先级或筛选条件冲突,不是匹配的问题。
目标是从「完美」的自动化转向「可靠」的自动化。前者要你天天维护,后者只需要把例外情况标出来交给人工看。如果你发现自己不停加新的排除条件,就为了管住机器人别乱动,那你其实没省下时间,只是把负担从分流消息挪到了审查自己的规则清单上。
先查这些失灵模式
规则不触发的时候,先别盯着平台 API,回头看看你的筛选条件堆栈。我们在几百个品牌身上都见过这种情况:团队往一条规则上叠了太多限制,不知不觉就造出了一个「不可能满足」的条件。
把它想成安检口。如果你要求访客必须来自某个品牌,还得是某个特定账号、某种特定对话类型,并且带着「紧急」优先标签,那你就造了一条极窄的通道。只要有一项对不上,比如一条消息进来时没带正式的「客服」标签,规则就整个跳过它。
规则悄悄失灵的常见元凶
- 逻辑重叠: 你有两条规则盯着同一个收件箱。如果规则 A 是「全收」,规则 B 很具体,但两者共享关键词,那规则 A 可能先把消息抢走了。
- 精确匹配陷阱: 你给「Help me」设了
exact精确匹配,可客户打的是「Help me!」(带感叹号)或者「help me」(小写)。字符串不完全一样,规则就漏了。 - 冷却期锁死: 如果你设了
cooldownHours为 24,客户两小时后又来追问,规则会忽略第二条消息。它以为自己还在休息。 - 筛选条件臃肿: 用
Platform: Twitter加ThreadType: Direct Message没问题。但再叠上Brand: Main和Priority: Critical,只要你的入站流量不是每个元数据字段都完美对上,规则往往就废了。
决策检查: 规则不触发了,就把生效的筛选条件砍掉一半。如果它又开始工作,你就知道是哪个筛选条件太严了。
分清信号和噪音的验证方法
想不再靠猜,最快的办法就是看执行日志。如果你在用 Mydrop,执行历史就是你的好帮手。它会告诉你规则在哪一刻尝试匹配、为什么匹配成功,或者为什么决定跳过这条对话。
没有日志,你就等于闭着眼睛开飞机,以为消息「没到」,其实它到了,只是没通过你的条件。用下面这张评分表,每周审查一次规则,直到找出瓶颈为止。
| 规则名称 | 匹配逻辑 | 筛选条件数 | 冷却时间(小时) | 执行状态 |
|---|---|---|---|---|
| 紧急客服 | contains_any |
2 | 1 | 稳定触发 |
| 一般咨询 | exact |
5 | 24 | 静默(失灵) |
| 反馈收集 | contains_all |
3 | 0 | 时有时无 |
这张评分表怎么看:
- 规则名称: 写得清楚点,一看就知道它管什么。
- 匹配逻辑: 如果你在用
contains_all,说明你太严了。社交用户很少会凑齐完美的词语组合。换成contains_any,看看抓取率有没有提升。 - 筛选条件数: 这个数字超过 3,你很可能正在把正常流量筛掉。
- 执行状态: 如果显示「已跳过:冷却中」,说明你的时间窗口太宽。如果显示「已跳过:筛选条件不匹配」,说明你的条件太死板。
大多数团队的问题不是自动化本身,而是逻辑该清理了。一旦你把那些其实没在为业务服务的筛选条件拿掉,你很可能会发现,80% 的「丢失」消息一夜之间就回到了自动队列里。
这周该修什么
如果你现在正被手动分流淹没,那接下来 48 小时的目标,就是把收件箱规则扒到只剩骨架。你很可能堆了一层又一层历史配置,都是某次活动时加的,后来一直没清理。
先用这套三步清理流程审查你正在生效的规则:
- 先放宽一遍: 挑出你最重要的三条「高流量」规则,把
contains_all逻辑换成contains_any。如果你还在死磕精确短语,那你就输给了那些用表情、缩写或者打错字的用户。 - 合并筛选条件: 看看那些失灵的规则。它们是不是只限定在一个品牌账号上,其实适用于五个?除非规则专门涉及地区合规,否则把那些细碎的平台和账号筛选条件都去掉。
- 重置冷却时间: 检查你的冷却窗口。如果常见客服咨询你设了 24 或 48 小时,那你很可能把同一个用户的追问都静音了。标准分流把冷却降到 1 到 2 小时,确保不会错过真正的用户不满。
在 Mydrop,我们看到很多团队只要删掉过去 30 天里一次动作都没触发过的规则,问题立刻就缓解了。一条规则如果帮不上你推进工作,那它只是在给你的诊断日志添噪音。
什么时候该停止诊断,直接改流程
到了某个点,规则的复杂度就不再是效率提升,而开始变成管理负担。如果你发现自己为了应付每种边缘情况,正在给「每件事都建一条规则」,那你就不是在自动化客服了,而是在造一台复杂又脆弱的机器,团队里没一个人能完全搞懂它。
如果你的规则集看起来像黑色侦探小说里的流程图,那就该转向人在环中的混合模式了。
别再想着给每种场景都编一个完美的 AI 自动回复。用规则来分流和打标签,然后把这些对话推到一个共享后台,交给人工看。这样回复质量能保持在高位,也不会出现品牌安全的机器人对着敏感客户投诉自动回复的尴尬场面。
流程检查: 如果你团队花在审查「这条自动回复为什么发出去」上的时间,比手动回复还多,那就把这条自动化关掉。
记住,收件箱规则的目标是处理那些可预测的高频噪音,让团队能专注在真正需要人来处理的消息上。当逻辑重到维护不动的时候,那不是工具失灵,而是说明你的团队已经超出了这套自动化策略的适用范围。
写在最后
把收件箱自动化,本该像请了个聪明助手,而不是像在管一堆复杂的服务器集群。规则漏消息了,别怪算法。先审查你自己的筛选条件堆栈,简化关键词逻辑,也接受一个事实:有些细微的判断,还是得交到团队手里。
我们合作过的最成功的品牌,规则并不是最复杂的,而是最稳定的。逻辑保持简单,冷却时间设得合理,人在环中的流程随时待命,等对话变复杂时能接得住。到周末,你的团队一定会为此谢谢你。

 Google 评价
 Trustpilot 评价
 Product Hunt comment





