
















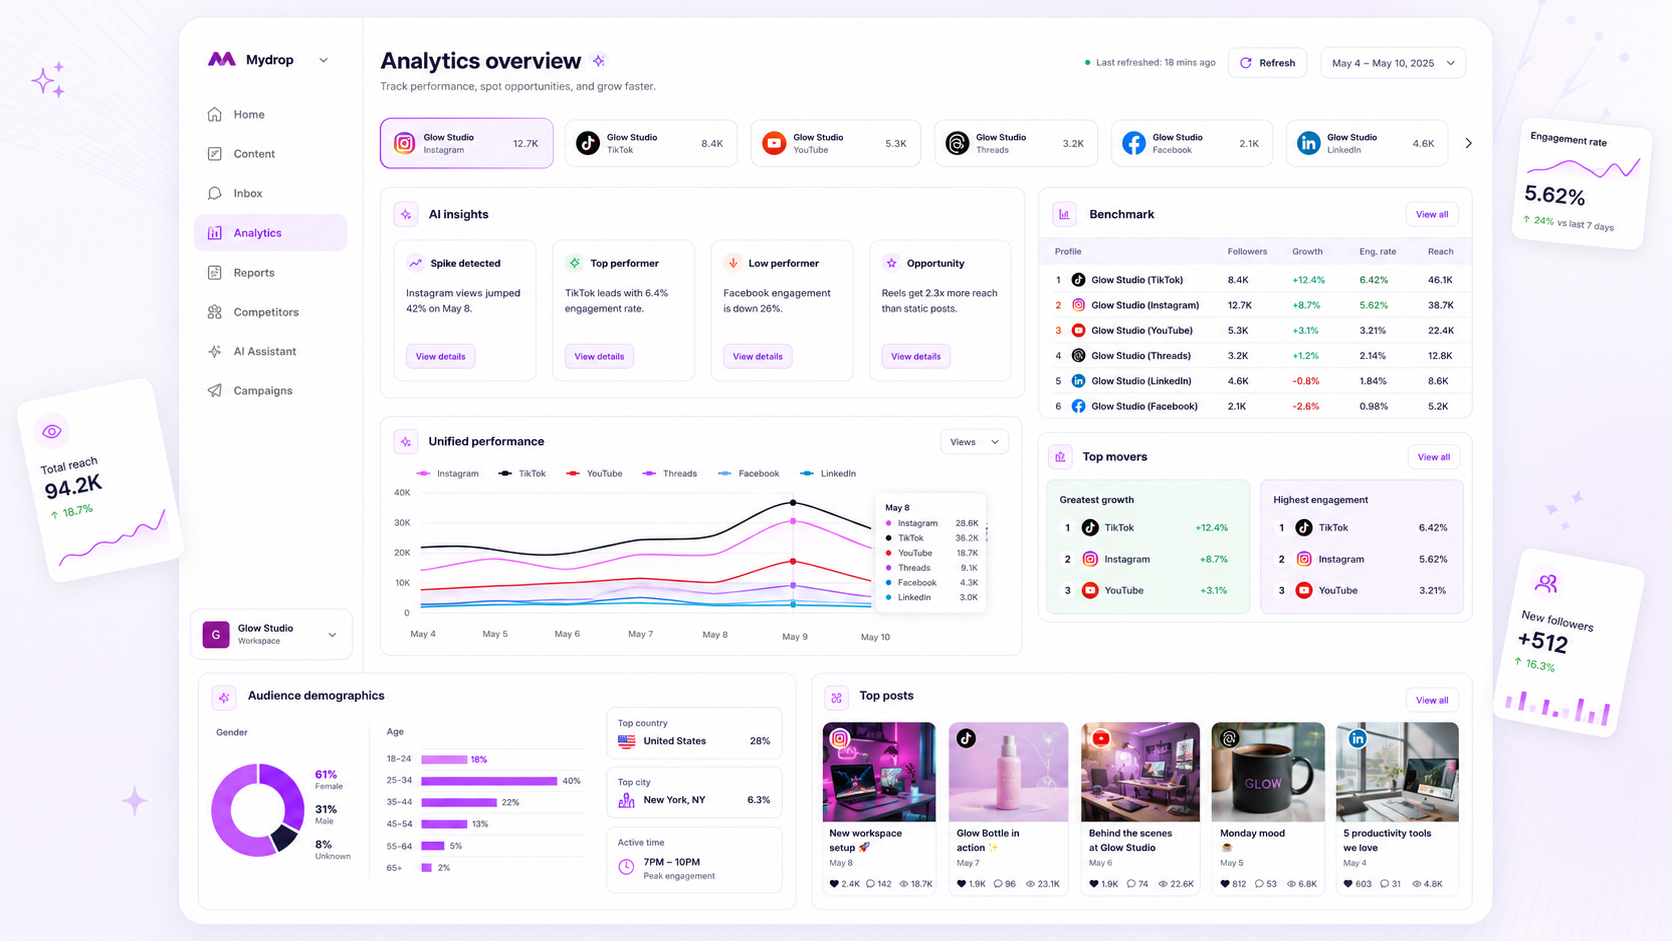
Arrête de vouloir régler une fatigue créative locale avec des données de plateforme globales. Sers-toi des benchmarks multi-profils pour isoler les problèmes systémiques de la plateforme, puis bascule sur les sous-collections d'un profil précis seulement quand tu as la preuve claire d'un goulot de performance localisé.
On te comprend : quand tu gères dix marques sur trente comptes, l'onglet Analytics ressemble moins à un outil stratégique qu'à un tuyau d'incendie de bruit. Tu croules sous les données mais tu meurs de soif de l'info précise qui justifie vraiment ton prochain pivot. Cet écart entre « les chiffres baissent » et « voilà ce qu'on doit changer », c'est là que la plupart des équipes brûlent leurs heures les plus précieuses.
Le vrai coût du reporting à grande échelle, c'est la taxe du changement de contexte. Les équipes passent souvent des heures à faire des audits approfondis sur des comptes qui vont très bien, juste parce qu'elles n'avaient pas les données de benchmark pour prouver que le problème n'était qu'une mauvaise semaine sur la plateforme.
Règle d'opérateur : Si ta portée baisse de 15 % sur absolument tous les comptes, arrête d'auditer le créatif. Tu regardes un mouvement de plateforme. Si ta portée baisse de 15 % sur un seul compte alors que les autres sont stables ou en hausse, le problème est posé sur ton bureau.
La décision que les équipes posent souvent trop large
La plupart des équipes traitent « Analytics » comme une destination. Comme un rapport à générer, à vérifier et à classer, plutôt qu'un vrai processus de diagnostic. Du coup, elles tombent dans l'un des deux extrêmes : soit elles restent dézoomées pour toujours sur les graphiques globaux, en ignorant les échecs individuels, soit elles passent en mode audit approfondi sur chaque profil, chaque semaine, quoi qu'il arrive.
Aucune des deux habitudes ne passe à l'échelle.
Quand tu traites le benchmark et l'audit comme une seule tâche, tu perds la capacité d'agir vite. Tu te retrouves avec un workflow qui ressemble à une scène de crime : des tableurs partout, vingt onglets ouverts, et une équipe épuisée à courir après des métriques qui ne font pas bouger les lignes.
Un simple changement de diagnostic change tout. En fixant un seuil clair pour passer de la vue d'ensemble au zoom chirurgical, tu élimines les devinettes. Tu arrêtes de traiter chaque « flèche vers le bas » comme une crise et tu commences à la lire comme un signal. Le but n'est pas de regarder plus de données, mais de regarder les bonnes données jusqu'à avoir la réponse.
Ce qui doit rester manuel et ce qui peut accélérer
Le plus gros gouffre à temps dans les opérations sociales modernes, c'est de traiter chaque point de données comme une mission « trouve la réponse ». Si tu rafraîchis les dashboards à la main chaque fois qu'un collègue demande « alors, elle donne quoi cette campagne ? », tu ne gères pas une marque : tu fais du baby-sitting de tableur.
Chez Mydrop, on voit les équipes tomber dans ce piège en permanence. Elles traitent le benchmark global comme s'il fallait le valider à la main en continu. En vrai, tes métriques systémiques de plateforme (portée, impressions, tendances de croissance d'abonnés) doivent être automatisées. Programme-les en rafraîchissement quotidien. Quand tu arrives au bureau, les données sont là, en cache, prêtes à l'emploi. Tu ne devrais jamais perdre ton café du matin à attendre qu'une API réponde.
Tout le reste ? Ça reste manuel.
Les plongées dans les sous-collections d'un profil précis sont tactiques par nature. Tu n'entres dans cette zone que quand le benchmark signale une dérive. Si l'engagement agrégé de ta plateforme tient bon à 3,2 % mais que ton profil « Lifestyle Brand » chute soudain à 1,8 %, c'est un problème chirurgical. C'est là que tu quittes le dashboard global et que tu creuses les visuels, les accroches et les horaires de publication de ce compte-là.
Point de contrôle : Ne rafraîchis jamais un dashboard à la main pour répondre à une question « quoi ». Utilise le cache automatique pour le « quoi », et garde ton énergie manuelle pour le « pourquoi ».
La matrice des compromis
Choisir le mauvais outil pour la tâche, c'est comme vouloir réparer une montre avec une masse. Tu casses le verre, mais tu ne répares sûrement pas le ressort. Utilise cette matrice pour couper le changement de contexte avant qu'il ne dévore ta semaine.
| Tâche de diagnostic | Périmètre | Valeur principale | Workflow Mydrop |
|---|---|---|---|
| Santé systémique | Multi-profils | Stabilité de référence | Consulte le tableau de bord Analytics (cache automatisé) |
| Audit créatif | Profil unique | Efficacité du contenu | Plonge dans les sous-collections de résultats (analyse manuelle) |
| Mouvement de marché | Multi-plateformes | Corrélation des tendances | Compare les résumés de benchmark (rafraîchissement système) |
| Crise/pic | Ponctuel | Contexte immédiat | Lance un rafraîchissement manuel (pour les données du jour) |
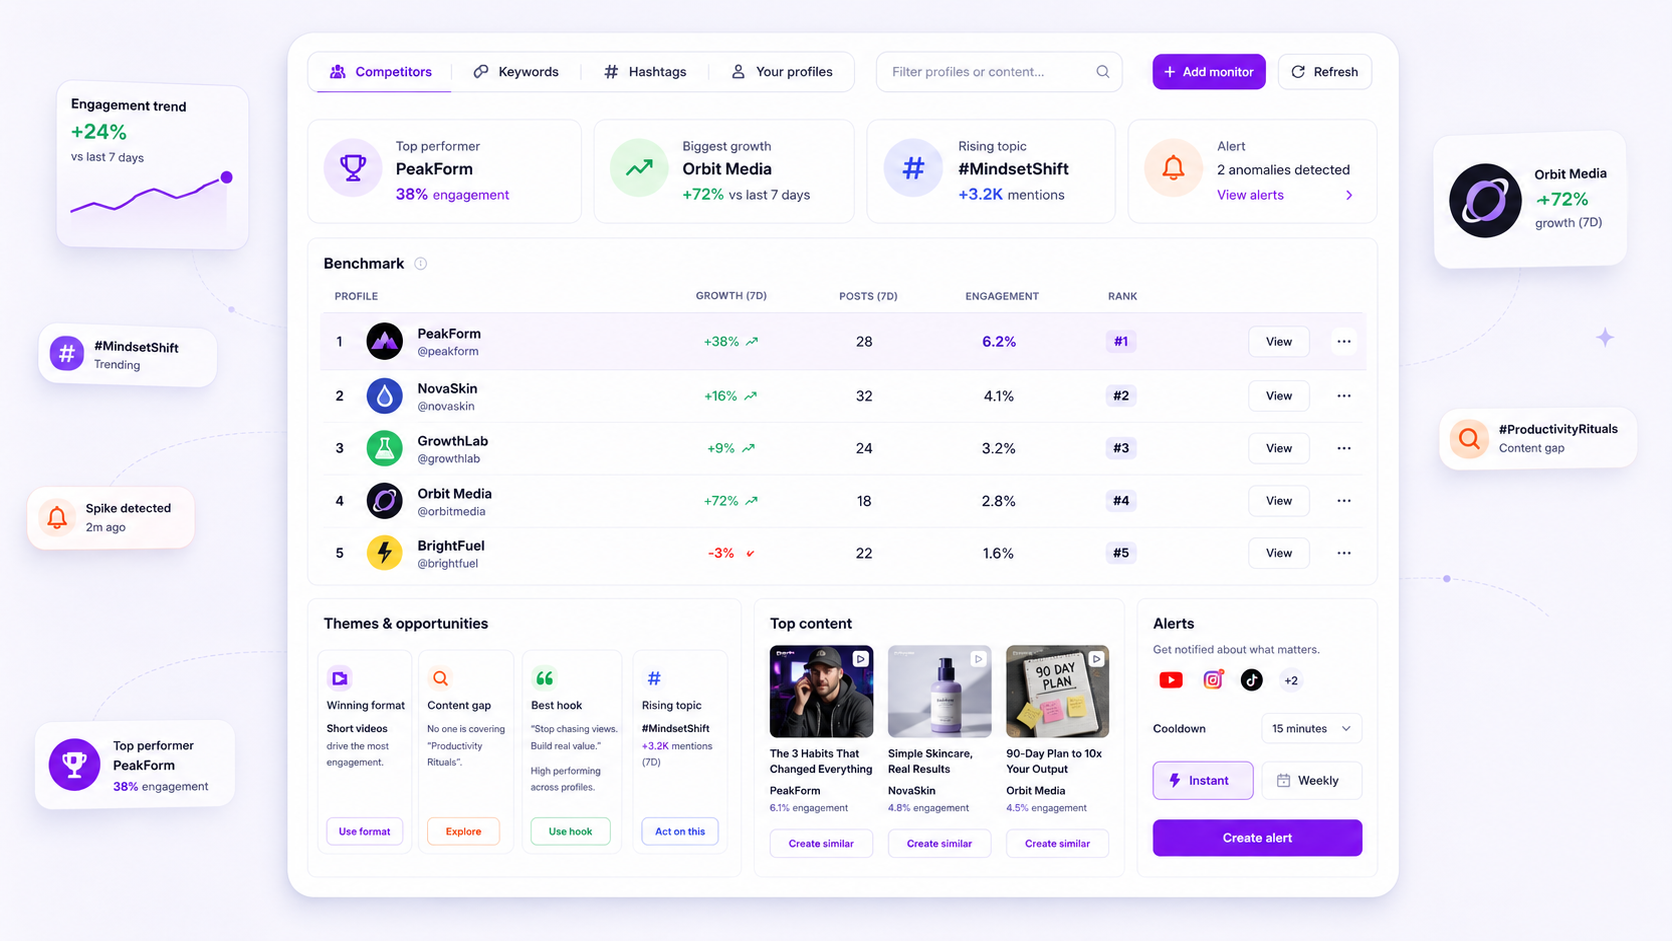
Si tu regardes plus de cinq profils à la fois, ne touche pas aux sous-collections. Reste sur les résumés de benchmark. Si tu cherches à optimiser le créatif d'un seul lancement, ne regarde pas le dashboard global. Les métriques larges vont juste masquer le signal créatif que tu dois voir.
Les équipes les plus disciplinées avec lesquelles on travaille ont un accord simple : le lundi, c'est benchmark ; le mercredi, c'est audit. En découplant les deux, elles évitent la panique qui monte quand quelqu'un voit une baisse sur un compte et conclut que toute la stratégie de marque s'effondre.
La plupart des équipes n'ont pas un problème de contenu. Elles ont un goulot de décision. En formalisant si tu es en « mode surveillance » ou en « mode chirurgie », tu arrêtes de deviner et tu passes à l'exécution. Avant d'ouvrir un nouvel onglet, demande-toi : je cherche un signal systémique ou un correctif local ? Si tu sais répondre, tu as déjà gagné une heure dans ta journée.
Comment tester le workflow sans risque
Pas besoin de refondre tout ton département d'ici lundi matin pour profiter de la séparation entre benchmarks systémiques et audits par profil. Commence par un pilote de deux semaines avec une de tes équipes marque les plus agiles.
- Désigne le référent benchmark : Chaque lundi matin, une personne passe 15 minutes dans ton dashboard Analytics Mydrop. Son job n'est pas de réparer quoi que ce soit, mais de rapporter le « signal système » : la portée monte, baisse ou stagne sur le portefeuille ?
- Définis le déclencheur : Mets-toi d'accord avec ton équipe sur ce que « hors du seuil attendu » veut dire pour vous. Si ton benchmark d'engagement moyen est à 3 %, tout profil qui passe sous 1,5 % deux jours de suite déclenche un audit approfondi.
- Audite le créatif, pas la plateforme : Quand un profil franchit ce déclencheur, résiste à l'envie d'accuser l'algorithme ou la connexion API. Utilise plutôt les sous-collections de résultats du profil pour chercher les coupables internes : le format du visuel était-il le bon ? Le texte s'éloignait-il de la voix de la marque ? L'heure de publication tombait-elle hors pic ?
En gardant le « signal système » sur le dashboard principal et en déplaçant le « zoom » vers les résultats du profil, tu évites le piège classique : auditer à la main chaque compte chaque jour. Tu verras que 80 % de tes comptes performent exactement comme prévu, ce qui laisse à ton équipe l'énergie pour les 20 % qui trébuchent vraiment.
La règle d'opération à garder
Pour empêcher ton équipe de retomber dans le reporting manuel façon tuyau d'incendie, ancre ton travail dans ce principe simple : n'audite jamais ce que tu ne peux pas expliquer avec un benchmark.
Point de contrôle : Si la performance d'un profil baisse, vérifie d'abord le benchmark multi-profils. Si toute la plateforme est en baisse pour tout le monde, c'est un problème système. Si seul ce profil baisse, c'est un problème d'exécution. Arrête de creuser tant que tu n'as pas cette réponse.
Quand tu gères des centaines de profils de marque, la tentation de « tout vérifier » est un symptôme de dette de coordination, pas de rigueur. C'est l'équivalent administratif de vérifier la serrure de ta porte cinquante fois avant de partir au boulot. Fais confiance au dashboard pour donner le pouls global, et fais confiance à ton équipe pour porter le gros du travail seulement quand le pouls montre une vraie anomalie.
Conclusion
La différence entre une équipe paniquée et une équipe efficace tient rarement au volume de données, mais plutôt à la discipline de savoir quoi ignorer. Quand tu arrêtes de traiter le dashboard Analytics comme un terrain de chasse aux problèmes et que tu commences à l'utiliser comme un outil de diagnostic pour prioriser le temps de ton équipe, tu passes de pompier réactif à opérateur proactif.
Tu as les outils pour voir ce qui se passe sur tout ton portefeuille. Sers-t'en pour séparer le bruit d'une mauvaise journée sur la plateforme du signal d'un vrai goulot créatif. En calant ton rythme sur benchmark d'abord, zoom ensuite, tu récupères les heures perdues en reporting manuel et tu redonnes à tes données ce qu'elles auraient toujours dû être : une carte pour ton prochain coup.
 Avis Google
 Avis Trustpilot
 Product Hunt comment





