
















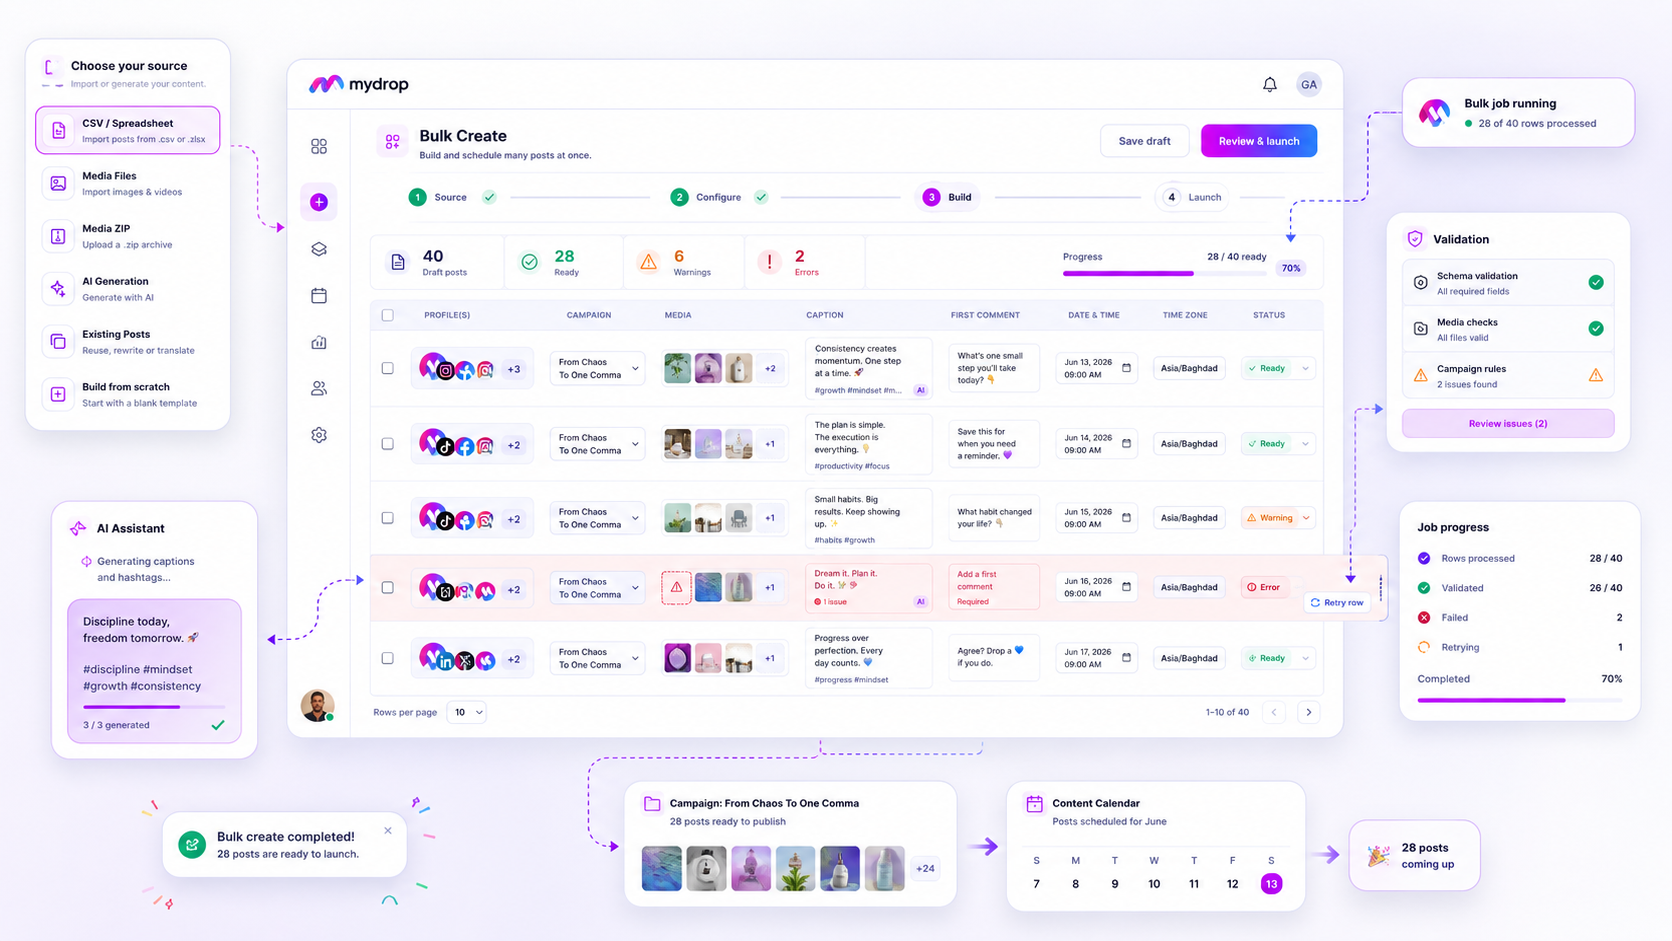
Quand ton upload de campagne en masse bloque à 40 %, arrête de marteler F5 et éloigne-toi du bouton re-upload. La plupart des échecs en masse ne sont pas des bugs système, mais des erreurs de signalement silencieuses : de minuscules écarts entre ton tableur et le schéma de la plateforme qui transforment un import de dix minutes en une heure de damage control manuel. Au lieu de supprimer le lot et de tout recommencer, traite l'échec comme un audit de diagnostic. Tu n'as pas besoin d'un tableur parfaitement clean : tu as besoin de la discipline d'isoler les lignes qui sont vraiment cassées.
On connaît la scène. Tu as un gros lancement de campagne et une douzaine de personnes qui campent sur tes notifs Slack. Quand la barre de progression se fige, la pression de « réparer ça vite » en repartant de zéro donne l'impression d'être le choix le plus sûr. C'est en fait le plus coûteux. Re-uploader dans la panique crée un paquet de doublons et de plannings qui se contredisent, et ça peut te hanter pendant des semaines.
Le piège : voir l'échec comme un tout
L'erreur que font la plupart des équipes, c'est de voir un échec en masse comme un état binaire : soit tout est importé, soit tout a planté. Résultat : le « piège du re-upload », avec deux campagnes à moitié finies et une montagne de nettoyage.
En vrai, les moteurs de création en masse sont pensés pour être granulaires. Quand tu traites les lignes par lots en parallèle, un échec à la ligne 52 n'annule pas les réussites des lignes 1 à 51. Le vrai raté opérationnel, c'est de traiter tout le lot comme un bloc monolithique au lieu d'une collection de posts individuels.
Sur les milliers de campagnes qu'on a vues, les équipes qui s'en sortent le mieux ne visent pas « l'import parfait ». Elles visent une « récupération haute résolution ». Elles utilisent un simple audit ligne par ligne pour distinguer les soucis de config systémiques des erreurs de données localisées.
Règle d'opérateur : si un job en masse plante, ta première action c'est d'identifier les IDs des lignes en échec, pas l'ID du job. Annule la panique, pas le lot.
Données Mydrop, septembre 2026 : dans les 30 jours précédant le 16 septembre 2026, 98,5 % des posts publiés via Mydrop ont été mis en ligne dès la première tentative. L'avertissement le plus fréquent était le rejet d'une miniature YouTube personnalisée car la chaîne n'était pas vérifiée par téléphone ; l'échec définitif le plus courant était une connexion à la plateforme expirée. Méthodologie dans les benchmarks Mydrop des réseaux sociaux.
Le tableau d'audit ci-dessous t'aide à savoir si tu as affaire à un problème structurel dans ta config ou à un simple décalage de données qu'un retry rapide peut régler.
| Symptôme | Cause la plus probable | Action de diagnostic |
|---|---|---|
| Job abandonné complètement | Structure CSV invalide ou schéma qui ne colle pas | Vérifie les noms d'en-têtes et les types de colonnes requis. |
| Plusieurs lignes en échec | Références médias incohérentes dans le ZIP/cloud | Vérifie que tous les chemins de fichiers image/vidéo sont valides. |
| Erreurs de lignes par intermittence | Limites de caractères ou contraintes de plateforme | Vérifie la longueur des légendes et les contraintes propres à chaque plateforme. |
| Statut « En file » qui bloque | Réseau ou connexion pendant le process async | Attends que le listener du job remonte l'état final. |
Dès que tu passes de « je refais le lot » à « je répare les lignes », tu arrêtes de subir ton automatisation : tu la pilotes. La plupart des échecs se règlent en vérifiant trois choses : la justesse du mapping des colonnes, l'intégrité des références médias et les limites de caractères. Quand tu isoles les lignes qui ont signalé une erreur, tu peux vérifier les données, corriger l'écart et utiliser un chemin de retry dédié pour ne pousser que les morceaux manquants dans le pipeline. Ton avancement est préservé, et tes parties prenantes restent contentes, même quand les données accrochent.
Ce qui doit rester manuel et ce qui peut accélérer
La plus grosse erreur qu'on voit, c'est de vouloir faire passer du contenu à fort contexte et à forte variabilité par le même tuyau que des posts de routine, evergreen. L'import en masse, c'est un miracle pour l'efficacité opérationnelle, mais ce n'est pas une potion magique pour la stratégie créa.
Si tu traites ton CSV comme une machine « je lance et j'oublie » pour tout, tu perds la nuance qui fait vraiment arrêter le scroll. Les updates de routine, les points d'avancement et les annonces urgentes avec visuels statiques sont parfaits pour le bulk. En revanche, le contenu de lancement à fort enjeu qui demande des retouches de dernière minute selon l'actu du secteur, ou des visuels qui ont besoin d'un étalonnage délicat, doivent rester dans ton workflow manuel de composition de post.
Si tu te surprends à repasser à la main sur des posts créés en masse parce que les réglages « bulk » n'ont pas capté la voix de la marque pour ce marché ou cette campagne, tu crées de la dette de coordination. En clair, tu fais le boulot deux fois.
La matrice des compromis
Pour décider ce qui s'automatise et ce qui mérite une touche humaine, sers-toi de cette matrice. Elle aide les équipes à savoir si un segment de campagne est « prêt pour le bulk » ou s'il doit rester entre les mains d'un campaign manager dédié.
| Segment de campagne | Potentiel d'automatisation | Règle de décision |
|---|---|---|
| Evergreen / Recycle | Élevé | Si le média existe et que le texte est standardisé, utilise Bulk Create. |
| Updates à faible risque | Élevé | Le bulk pour les alertes standard ; garde le temps manuel pour l'engagement. |
| Lancements à fort enjeu | Faible | La relecture manuelle est obligatoire pour coller au marché local. |
| Formats expérimentaux | Faible | Si le format est nouveau, un œil humain évite les bugs d'affichage côté plateforme. |
| Données à haute fréquence | Élevé | À utiliser pour le contenu répétitif ; garde le manuel pour les surprises « événementielles ». |
Check de décision : n'importe jamais en masse du contenu qui n'a pas été validé dans sa forme finale, avec tous ses assets. Utiliser le bulk comme « bac à sable » pour du contenu inachevé, c'est 100 lignes en échec et un après-midi très compliqué.
Chez Mydrop, on voit des milliers de workflows, et les équipes qui réussissent traitent l'automatisation en masse comme un outil spécialisé, pas comme un état par défaut. Elles réservent le moteur bulk-create au gros du boulot de distribution des campagnes, pour que leur équipe créa reste libre de se concentrer sur les 20 % de contenu qui définissent vraiment la perf trimestrielle de la marque.
Le but n'est pas d'automatiser 100 % de ta présence sociale. C'est d'automatiser la friction dans ta chaîne de prod, pour pouvoir t'offrir le temps d'être humain là où ça compte le plus. Quand tu arrêtes d'essayer d'uploader en masse ton âme créative, tu découvres que les quelques lignes qui plantent sont bien plus faciles à gérer. Tu arrêtes de paniquer sur le lot et tu te concentres sur la ligne précise qui a besoin d'un coup de pouce.
Comment tester le workflow sans risque
Quand tu pousses un gros lot, la différence entre une petite contrariété et une crise totale, c'est ta réaction au premier signe de texte rouge. Pas besoin de tout mettre en pause juste parce que quelques lignes n'ont pas passé la validation.
Les équipes les plus efficaces ne voient pas le Bulk Jobs Listener comme un simple moniteur de statut, mais comme un vrai centre de commande. Quand tu vois une notif d'échec, le réflexe c'est de jeter le lot et de tout réimporter. Résiste. C'est presque toujours plus propre de laisser le job finir, puis d'inspecter les erreurs précises.
Voici comment gérer le « milieu chaotique » comme un pro :
- Reste sur le job : si le job tourne encore, laisse le worker finir. Fermer la fenêtre ou forcer une annulation crée souvent plus de nettoyage, parce que le système doit annuler des posts à moitié terminés.
- Filtre sur l'échec : une fois le job stabilisé, file dans l'historique des jobs. Utilise la vue pour isoler uniquement les lignes
failed. Pas besoin de toucher aux lignes réussies. - Fais un audit chirurgical : regarde l'erreur précise d'une ligne. En général, c'est un simple décalage : un format de date mal interprété ou un lien d'image mort. Une fois que tu as le pattern, tu peux souvent corriger toutes les lignes en échec d'un coup.
- Lance le retry ciblé : utilise la fonction retry failed rows. Elle contourne le travail déjà réussi, préserve ton planning et fait disparaître ta notif de progression une fois le lot propre.
Check workflow : ne jette jamais un lot avant d'avoir exporté le log d'erreurs. La plupart des échecs en masse viennent d'une seule colonne mal configurée ou d'un fichier média manquant dans un dossier de deux cents. Corrige la source, relance les lignes en échec, et avance.
La règle de fonctionnement à garder
Le but ultime des outils en masse, ce n'est pas juste d'économiser des clics : c'est de construire une chaîne d'appro de contenu prévisible. Si ton équipe passe son temps à déboguer les mêmes soucis de formatage CSV, tu paies une « taxe de coordination » à chaque lancement.
On a constaté que les équipes qui passent du « je répare dans la panique » à « j'audite mon process » voient leur temps de bouclage de campagne chuter nettement. En standardisant tes modèles d'import et en faisant un petit audit en 5 points sur tes données source avant de cliquer sur upload, tu déplaces le point de rupture de « en production » à « avant décollage ».
Conclusion
La gestion de campagne en masse donne l'impression d'être à haut risque, parce qu'elle tombe souvent au moment où la pression est à son max. Mais la réalité, c'est qu'un import qui plante est rarement une catastrophe : c'est juste un signal de diagnostic qui dit qu'un truc dans ta préparation ne collait pas aux exigences de la plateforme.
Arrête de voir la barre de progression comme un test réussi/raté. Vois-la comme une boucle. Tu construis tes lignes, tu valides le lot, et quand une ligne plante (pas si, quand), tu t'en sers comme d'un point de données pour affiner ton modèle. Chez Mydrop, on voit les agences et les marques qui marchent le mieux traiter leur usine à campagnes comme un système itératif. Elles ne visent pas des uploads parfaits : elles visent des chemins de récupération propres, rapides et répétables. Quand tu arrêtes de craindre le statut « failed » et que tu commences à t'en servir pour repérer où ta chaîne casse, tu arrêtes d'être pompier et tu deviens éditeur.

 Avis Google
 Avis Trustpilot
 Product Hunt comment





