
















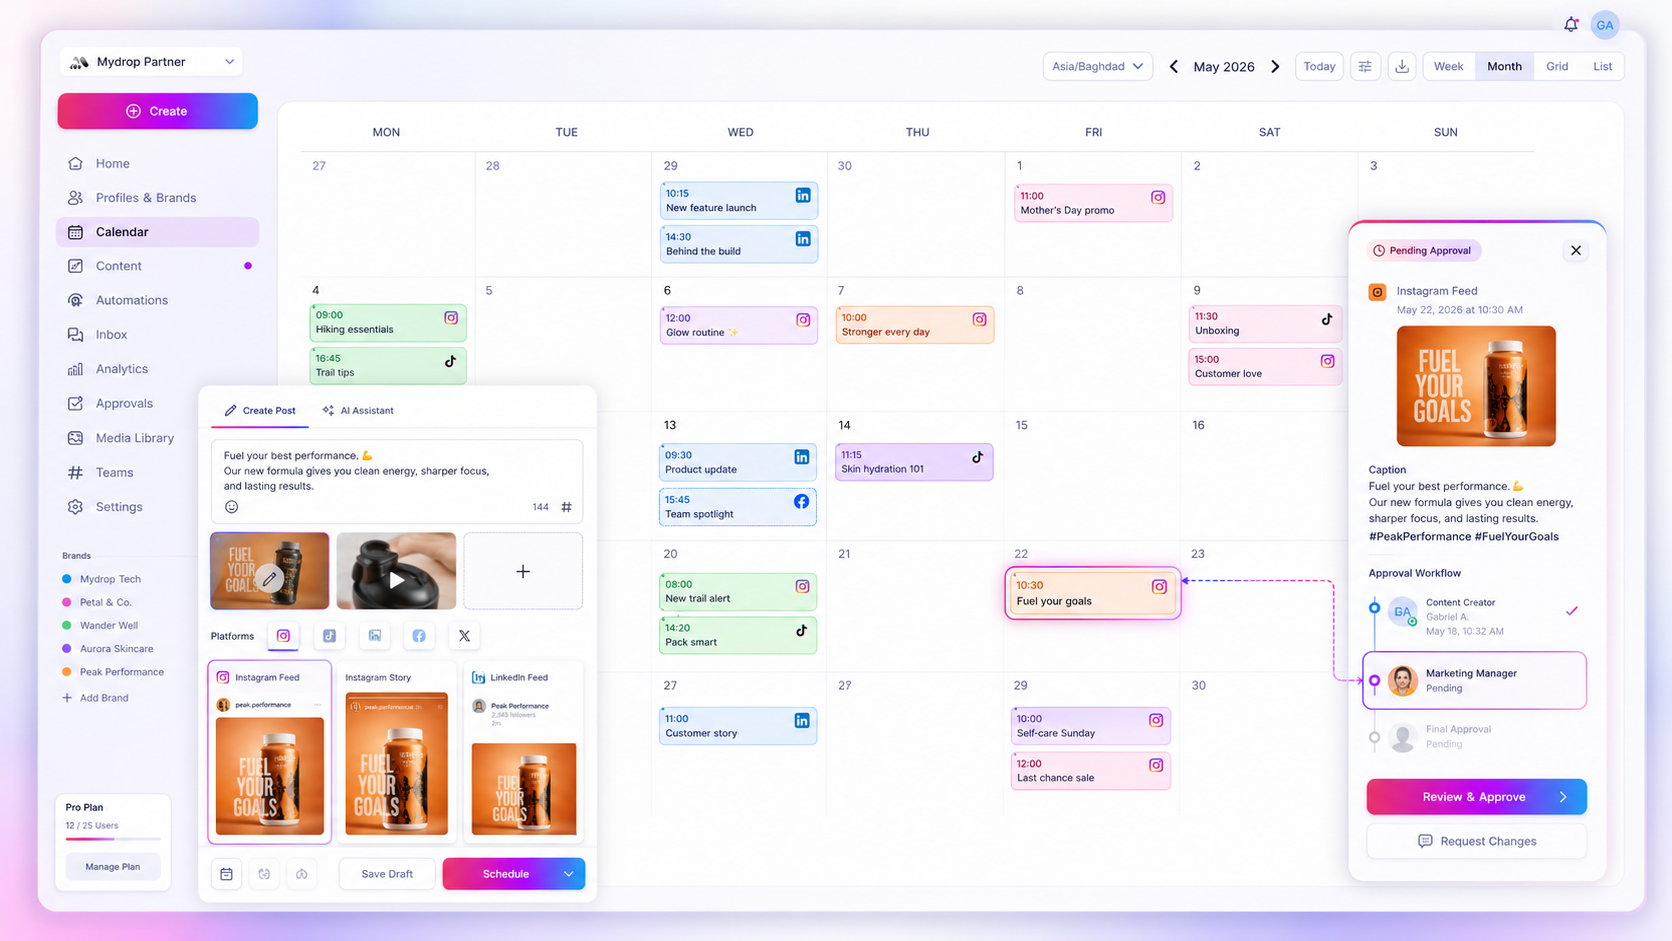
Estandarizar tu proceso de distribución en una única fuente de verdad inmutable es la única forma de acabar con la deuda de coordinación que lastra a los equipos de social con mucho volumen. Si tu marca gestiona decenas de canales en varios mercados, el hueco entre pulsar aprobar y verificar que el post está publicado es justo donde muere el ROI de la campaña.
Te entendemos. Vives atrapado entre recursos creativos, trabas de compliance y tareas manuales sin fin. Seguro que sientes que peleas contra los bugs de las plataformas o que persigues a los stakeholders a las 6 de la tarde solo para publicar una simple actualización. No es solo agotador: es un fallo estructural. Cuando tu equipo trata la publicación como una ristra de recados manuales sueltos y no como un ciclo de despliegue bien armado, los errores están cantados: enlaces roscos, miniaturas que faltan o conversiones de zona horaria mal hechas.
Regla de operador: un post no está "terminado" hasta que la plataforma ha confirmado la recepción y tu sistema ha conciliado ese estado. Todo lo demás es un borrador.
Datos de Mydrop, septiembre de 2026: en los 30 días hasta el 16 de septiembre de 2026, el 98,5% de las publicaciones publicadas a través de Mydrop se publicó al primer intento. El aviso más común fue una miniatura personalizada de YouTube rechazada porque el canal no estaba verificado por teléfono; el fallo grave más común fue una conexión de plataforma caducada. Metodología en los benchmarks de redes sociales de Mydrop.
Lo que tienen que resolver las mejores herramientas
El error más habitual que vemos en cientos de perfiles de marca es usar herramientas que brillan en la fase creativa pero se apagan en cuanto llega la hora cero. Los equipos enterprise necesitan algo más que un programador simple: necesitan una infraestructura que trate cada post como un objeto vivo que sigue su propio ciclo de vida.
Si estás evaluando tu configuración actual, fíjate en estos requisitos básicos que separan las herramientas profesionales de las pensadas para un solo creador.
| Capacidad | Por qué importa | Riesgo en enterprise |
|---|---|---|
| Estado canónico | Garantiza que el registro del post coincide con la realidad publicada. | Posts fantasma que aparecen como "programados" pero nunca se lanzaron. |
| Conciliación asíncrona | Detecta automáticamente los avisos que manda la plataforma. | Posts "publicados con éxito" que en realidad están bloqueados o restringidos. |
| Borrado atómico | Elimina el trabajo de la cola y de la plataforma. | Posts huérfanos que se quedan en los buffers de la plataforma tras cancelarlos. |
| Validación de esquema | Comprueba los límites de cada canal antes de entrar. | Ciclos enormes de rehacer trabajo cuando una auditoría detecta formatos que no encajan. |
En Mydrop hemos construido nuestro modelo canónico del post sobre estas realidades. No lanzamos una petición y a ver qué pasa. Cuando programas un post, nuestro Cloud Scheduler crea un trabajo duradero que queda atado a tu documento central del post. Si una plataforma devuelve un error de cuota o un aviso por restricción de formato, el sistema no se traga el fallo: actualiza tu estado a aviso o fallido, lanza una notificación y registra el error concreto para que no te quedes adivinando por qué tu vídeo no llegó al feed.
Las mejores herramientas priorizan la visibilidad por encima de la velocidad. Cuando sabes exactamente en qué punto del camino está un post (si está en espera, pendiente, publicado o atrapado en un bucle de límite de peticiones de la API), dejas de hacer de detective y empiezas a gestionar tu estrategia. Necesitas un sistema que funcione como una extensión de tus operaciones y se encargue de la "última milla" de la entrega, para que tu equipo se centre en el siguiente gran empujón creativo.
Dónde empiezan a fallar las herramientas básicas
Casi todos los programadores de redes sociales básicos tratan cada post como un evento aislado. Redactas, eliges una hora y se lanza. Pero cuando tu equipo gestiona decenas de perfiles en tres zonas horarias, ese enfoque aislado genera lo que llamamos "desgaste de sincronización". Acabas con un montón de tareas fragmentadas que pierden el contacto con la realidad en cuanto salen de tu panel.
Las grietas aparecen de tres formas concretas:
- El agujero negro del estado: ves "programado" en tu herramienta, pero la API de la plataforma devuelve un error silencioso porque tu token de acceso caducó o tu formato de recurso activó un rechazo raro. Tu herramienta sigue mostrando una marca verde mientras tu perfil real sigue vacío.
- Deriva en las aprobaciones: cuando el proceso de aprobación vive en otra herramienta, o peor, en un hilo de email, la versión del post que se aprueba muchas veces no es la que se sube. Básicamente, juegas al teléfono escacharrado con tu propio calendario de contenidos.
- Asincronía del proveedor: redes como LinkedIn o TikTok no siempre te dan un "sí" o un "no" al instante. Pueden devolver un "aviso" o un fallo parcial, como una miniatura que falta en un vídeo. Los programadores básicos suelen tomarlo como un éxito total, y tu equipo acaba revisando a mano cada enlace, comentario y recurso mucho después.
En Mydrop lo vemos en cientos de perfiles de marca: cuanto más escalas, menos importa "programar" y más importa "gestionar estados". Si tu sistema no sabe exactamente qué ve la plataforma, vas a ciegas.
Los criterios de compra que de verdad importan
Cuando estés listo para ir más allá de las herramientas básicas, deja de buscar más funciones y empieza a buscar integridad arquitectónica. Necesitas una plataforma que trate tu calendario de contenidos como un sistema vivo y observable, no como una lista de tareas estática.
Usa esta tabla de evaluación para comprobar si una herramienta aguanta la carga de una operación de marketing seria.
| Métrica de evaluación | El fallo del modelo "estático" | El estándar enterprise |
|---|---|---|
| Conciliación de estado | Da por hecho el éxito si no hay error inmediato. | Verifica solo el estado vía API de la plataforma tras publicar. |
| Blindaje de recursos | Permite formatos de archivo que no encajan. | Impone la proporción y el tamaño específicos de cada plataforma al subir. |
| Fiabilidad del trabajo | Depende de lanzamientos manuales de "publicar ahora". | Ejecución canónica en la nube que reintenta ante errores puntuales. |
| Lógica de notificaciones | Solo avisa cuando el fallo es total. | Avisos proactivos de advertencias, cuotas cerca del límite y publicaciones parciales. |
Comprobación rápida: si tu herramienta no distingue entre un "trabajo programado" y un "post confirmado y publicado", no es una plataforma enterprise. Es una app de recordatorios con ínfulas.
Cuando audites a tu proveedor actual, mira sus registros de errores. Si solo informan de "fallido" o "correcto", se están perdiendo el fallo más común: el éxito parcial. Una plataforma que no muestra los avisos específicos de cada red, como la cercanía al límite de peticiones o la falta de miniaturas de vídeo, es un riesgo operativo.
Tu objetivo es la consistencia canónica. Quieres un sistema donde la representación interna del post y el estado externo en la red social estén enganchados en un bucle de feedback continuo y automático. Si un post se topa con un muro, tu sistema debería saberlo, marcarlo con un aviso y avisar a tu equipo antes de que los stakeholders empiecen a preguntar "¿y el post?".
No te conformes con una herramienta que te promete más alcance si no puede garantizar que tu contenido llegará de verdad donde lo enviaste. Una máquina fiable gana a una rápida siempre.
Cómo Mydrop ayuda con este flujo de trabajo
En Mydrop vemos los mismos patrones en miles de perfiles: los equipos no fallan por falta de creatividad, sino porque su sistema nervioso central para distribuir contenido está fragmentado. Por eso construimos nuestro motor de programación y publicación como una única fuente de verdad inmutable.
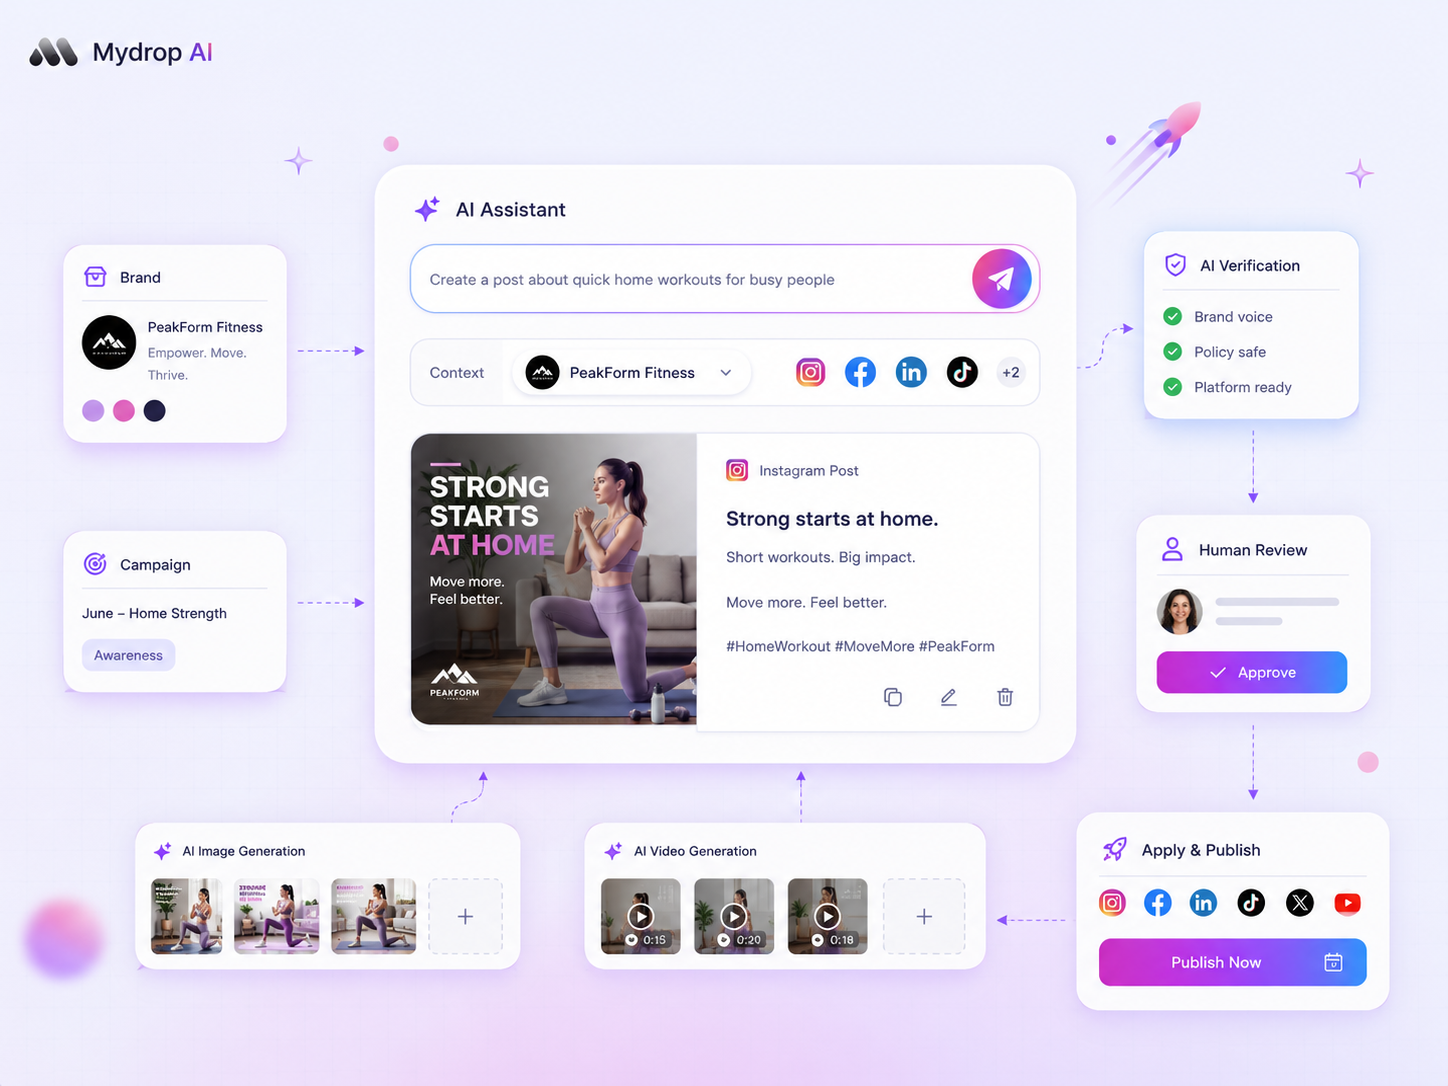
En lugar de tratar un post como una acción puntual de "lanzar y olvidar", Mydrop mantiene cada actualización como un objeto canónico desde tu primer borrador hasta el momento en que recibe la confirmación final de la API de la plataforma. Cuando programas un reel para Instagram o un anuncio multiplataforma en LinkedIn y X, nuestro sistema gestiona la cola de trabajos, se ocupa de los requisitos de token de cada plataforma y registra el resultado. Si una plataforma lanza un aviso de límite de peticiones o un desajuste de miniatura, no te quedas rebuscando en los registros: el estado del post se actualiza al momento en tu vista de calendario. Así tu equipo pasa de la conciliación manual a la gestión de excepciones, y solo interviene cuando el sistema marca un obstáculo concreto.
Comprobación del flujo: cada post debería ser una única fuente de verdad. Si tu sistema de registro dice que un post está "publicado" pero la plataforma real dice "pendiente", tienes un fallo de coordinación.
Una checklist sencilla para hacer tu criba
Antes de comprometerte con una nueva herramienta de programación o de auditar tu stack actual, pasa tu flujo por este chequeo de 5 puntos. Si no puedes marcar todos, probablemente cargas con más trabajo operativo del necesario.
| Función | El requisito enterprise | Por qué importa |
|---|---|---|
| Visibilidad del estado | Actualizaciones de estado en tiempo real | Necesitas saber si de verdad se publicó, no solo si el trabajo se lanzó. |
| Actualizaciones atómicas | Editar objetos ya publicados | Cambiar un pie de foto o un enlace debería actualizar el objeto canónico en todas partes. |
| Lógica de plataforma | Gestión nativa de campos | Tu herramienta debe aplicar los límites de caracteres o las especificaciones de cada red antes de llamar a la API. |
| A prueba de fallos | Información de error detallada | Distinguir entre un "fallo grave" y un "aviso del proveedor" para priorizar las correcciones. |
| Sincronización | Integración con el calendario | Si tu calendario social no refleja tu calendario interno de proyectos, estás duplicando el trabajo. |
Conclusión
Gestionar la distribución en redes a escala se parece menos a dirigir un estudio creativo y más a gestionar un despliegue de software en remoto. Llevas APIs volátiles, reglas de plataforma que cambian y ventanas de lanzamiento a presión.
El objetivo es dejar de pensar en "publicar" como una tarea manual y empezar a tratar tu proceso de distribución como una pieza de infraestructura bien armada. Cuando quitas la fricción (las comprobaciones constantes, las republicaciones a mano y los hilos de aprobación rotos), por fin le das a tu equipo el espacio para centrarse en el contenido que de verdad mueve la aguja para tu marca.
Audita tu flujo actual, localiza dónde están los traspasos manuales y sustitúyelos por un sistema unificado que se encargue del trabajo pesado de la verificación. Tu equipo te lo agradecerá, y tus analíticas lo notarán.
 Reseña en Google
 Reseña en Trustpilot
 Product Hunt comment





