
















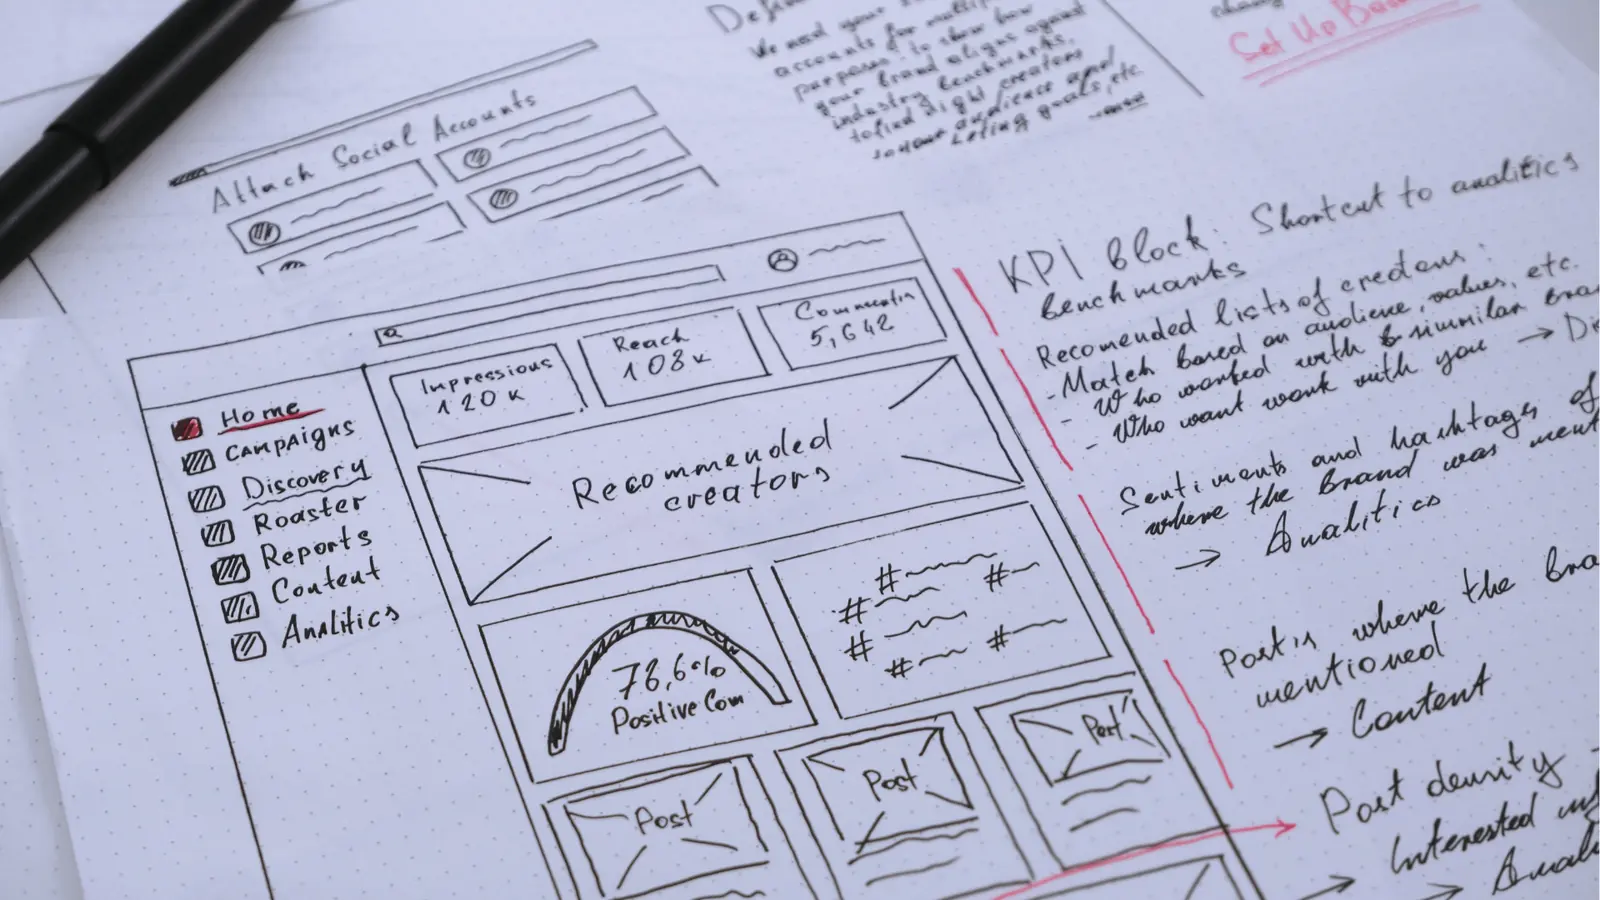
Eine globale CPG-Marke launcht einen neuen Snack in der EU und den USA: mit versetzten Influencer-Wellen, unterschiedlichen Spend-Caps pro Markt und dem Auftrag, in den ersten vier Wochen auf Tempo zu kommen. Zwei Wochen später läuft die Kampagne in einem Markt schlecht, die Rechtsabteilung meldet ein Offenlegungsproblem, das einen Top-Creator mehrere Tage ausbremst, und Finance will sofort umschichten, um keine Media-Budgets zu verbrennen. Das Team hat drei Dashboards, zwei Spreadsheets und keine einzige verlässliche Quelle dafür, welche Creator tatsächlich Conversions gebracht haben. Die Folge: überstürzte Entscheidungen, doppelte Ansprache und geschätzt 20 bis 30 Prozent des bezahlten Mikrobudgets, das noch zu retten gewesen wäre, wenn jemand gewusst hätte, wo man das Geld in Sicherheit bringt und wo man stärker nachlegt.
Mydrop-Daten, September 2026: die Zahlen, die ins Briefing gehören statt "Engagement steigern", aus Posts mit gemeldeter Engagement-Rate auf mit Mydrop verbundenen Accounts, auf denen Mydrop 55.000+ Posts verwaltet, rollierende 180 Tage.
| Plattform | Median Engagement-Rate | Mittlere Hälfte der Posts |
|---|---|---|
| 5,26% | 0,00% bis 9,09% | |
| YouTube | 3,85% | 1,53% bis 10,59% |
| 3,08% | 1,06% bis 6,71% | |
| TikTok | 2,98% | 1,77% bis 6,55% |
| 1,11% | 0,36% bis 3,14% |
Die mittlere Hälfte ist das 25. bis 75. Perzentil, also liegt die Hälfte aller Posts darin. Ein Ziel über dem 75. Perzentil ist ein Stretch-Ziel, kein KPI. Pinterest und YouTube sind als Richtwert zu lesen. Methode und vollständige Tabellen in den Mydrop Social-Media-Benchmarks.
Dieser Druck ist normal für Enterprise-Programme: viele Marken, viele Stakeholder, enge Launch-Fenster und kaum Spielraum für Überraschungen. Beim Prognostizieren von Influencer-ROI geht es nicht um perfekte Vorhersagen. Es geht darum, aus diesem chaotischen operativen Alltag einen wiederholbaren Rhythmus zu machen: Das Modell liefert brauchbare Prognosen, die Sensoren erkennen Abweichungen, und klare Entscheidungsregeln verhindern Panik. Ein guter Forecast funktioniert wie ein Wetterbericht: Er sagt dir, in welchen Märkten die Sonne scheint, wo ein Sturm aufziehen könnte und welche Creator Blitzrisiken sind. Wenn der Forecast glaubwürdig ist, gehen Freigaben schneller, Legal-Reviews werden nach Risiko sortiert, und Finance schichtet mit Zuversicht um statt aus dem Bauch.
Fang beim echten Business-Problem an
Fang mit einer präzisen Frage mit hohem Einsatz an, nicht mit einem Modell. Im CPG-Beispiel lautet die Frage: Wie viel des Launch-Budgets sollten wir in Woche eins pro Markt fest einplanen, damit wir die Trial-KPIs bis Woche vier treffen, und dabei 10 Prozent Reserve für Compliance- oder Creative-Themen behalten? Diese eine Entscheidung verbindet Spend-Pacing, Creative-Kadenz, Creator-Auswahl und den Freigabe-Workflow. Hier hängen Teams typischerweise fest: Sie bauen Dashboards, die dreißig verschiedene Fragen schlecht beantworten, und geben dann den Daten die Schuld, wenn das Programm seine Ziele verfehlt. Ein brauchbarer Forecast richtet sich nach dem Entscheidungszeitplan. Wenn Entscheidungen innerhalb von 48 Stunden fallen müssen, um den Launch-Momentum zu schützen, müssen Modell und operatives Playbook genau diesen 48-Stunden-Zyklus bedienen.
Als Nächstes: Mach dir ein Bild von den operativen Fehlermodi, die du siehst, wenn der Forecast danebenliegt. Typische Beispiele: Uneinheitliches UTM-Tagging lässt Attribution-Proxies über Märkte hinweg brechen; regionale Agenturen reichen unterschiedliche Creative-Specs ein und der Content-Kalender zerfasert; Legal-Reviewer gehen unter, weil Flags nicht nach Risiko triagiert werden; und Finance schichtet anhand von Vanity-Metriken wie Impressions um statt anhand inkrementeller Conversions. Jeder dieser Fehler hat einen Fix, der außerhalb der Statistik liegt. Eine einheitliche Tagging-Konvention, durchgesetzt per Automatisierung und geteiltem Content-Kalender, reduziert Doppelarbeit und beschleunigt Entscheidungen. Mydrop hilft hier, indem Creator-Metadaten, Freigaben und UTM-Links zentral zusammenlaufen, sodass die Forecast-Engine konsistente Inputs bekommt und die Sensoren dieselben Signale lesen, denen alle vertrauen.
Bevor du irgendetwas baust, einigt euch auf drei einfache Entscheidungen, die das Team zuerst treffen muss. Diese Entscheidungen werden die Single-Source-Ziele, auf die der Forecast optimiert:
- Budget-Split und Reserve-Regel: Wie viel des Gesamtbudgets geht in die Primärmärkte, und wie viel bleibt für Eventualitäten zurück.
- Pacing-Trigger-Schwellen: exakte Engagement- oder Conversion-Werte, die innerhalb von 48 Stunden eine Pause, Umschichtung oder Skalierung auslösen.
- Creator-Risiko-Tiering: welche Creator bei Compliance-Flags automatisch pausiert werden und welche ein manuelles Legal-Review brauchen.
Diesen Punkt unterschätzen die meisten: Governance schlägt Modellkomplexität. Wenn der Legal-Reviewer die einzige Person ist, die einen Mid-Tier-Creator freigeben kann, und in einer anderen Zeitzone sitzt, ist ein Forecast, der eine Spend-Umschichtung empfiehlt, nutzlos, solange die Governance-Regeln niemand anderem erlauben, unter definierten Bedingungen zu handeln. Bring diese Regeln auf dieselbe Kadenz wie den Forecast. Wenn zum Beispiel die Engagement-Velocity unter X fällt und der Conversion-Lift 48 Stunden lang unter Y bleibt, pausiert ein vorab definierter Flow die bezahlte Verstärkung und tauscht zwei Standby-Creator aus dem Roster ein. Diese Übergabe reduziert Freigabe-Reibung und verhindert Tage voller blockierter Spend, während das Team diskutiert.
Zum Schluss: Quantifiziere die Entscheidungsfenster und die akzeptable Fehlermarge für jeden Stakeholder. Finance toleriert einen breiteren Forecast-Fehler bei der Reichweite, verlangt aber enge Kontrolle bei verschwendetem Spend. Brand-Teams achten auf Messaging-Konsistenz und akzeptieren vielleicht eine langsamere Pause-Schwelle, um Creative-Churn zu vermeiden. Social Ops braucht klare Sensoren, um Compliance- oder Performance-Drift zu erkennen. Übersetze diese Toleranzen in Modellanforderungen: Eine Faustregel-Heuristik reicht vielleicht für eine brand-sichere Ankündigung, eine Regression passt für die Vorhersage von Conversion-Proxies, wo First-Party-Daten existieren, und ein probabilistisches Zeitreihenmodell ist den Aufwand wert, wenn du enge Konfidenzintervalle über mehrere Launch-Wellen brauchst. Wenn du die Toleranzen vorab abstimmst, vermeidest du die vorhersehbare Diskussion später, in der das Modell beschuldigt wird, „nicht präzise genug“ zu sein, obwohl die Stakeholder Unterschiedliches verlangt haben.
Ein kurzes, konkretes Beispiel macht die Tradeoffs klar. Beim CPG-Launch setzte das Team 10 Prozent Reserve für Compliance-Eventualitäten fest, ein 48-Stunden-Entscheidungsfenster für Spend-Umschichtungen und die Regel, dass Creator mit früheren Offenlegungs-Flags auf eine Watchlist kommen, auf der jedes neue Flag eine sofortige Pause auslöst. Für die ersten Splits nutzten sie eine einfache Regression auf vergangene Creator-Conversion-Rates, bauten aber Echtzeit-Sensoren für Engagement-Velocity und UTM-getriebene Landingpage-Conversions. Als ein Top-Creator in der EU nach drei Posts bei der Conversion-Velocity 30 Prozent hinterherlag, meldete der Sensor das Problem, die Standby-Creator wurden unter den vorab vereinbarten Governance-Regeln automatisch für Verstärkung freigegeben, und der Spend wurde innerhalb des 48-Stunden-Fensters verschoben. Das Ergebnis: ein geringerer Rückgang bei den Trial-Signups und ein geretteter Teil des bezahlten Budgets, der sonst während der Legal-Review-Verzögerungen verloren gegangen wäre.
Halte den ersten Scope eng. Forecasts scheitern, wenn Teams alles auf einmal vorhersagen wollen. Nimm den Markt oder die Marke mit dem klarsten Entscheidungsfenster und den besten Daten als Startpunkt. Fahre einen zweiwöchigen Pilot, der die Sensoren, die Entscheidungsschwellen und die Übergaben zwischen Brand, Legal und Agentur validiert. Feiere den ersten geretteten Dollar oder den ersten vermiedenen Compliance-Vorfall: Kleine, glaubwürdige Erfolge bauen das Vertrauen auf, mit dem du die Forecast-Engine auf weitere Marken und Regionen ausdehnst.
Wähl das Modell, das zu deinem Team passt
Behandle die Modellwahl wie die Wahl des richtigen Forecast-Instruments für das Wetter, das du erwartest. Fang mit der Größe der Entscheidung an: Brauchst du eine schnelle Regel, um stündlichen Spend zu steuern, oder eine probabilistische Sicht, die Unsicherheit über Märkte hinweg quantifiziert? Wenn dein Team größtenteils aus Marketing Ops mit ein paar Analysten und fragmentierten Datenwinden besteht (drei Dashboards, zwei Spreadsheets, kommt dir das bekannt vor?), ist eine einfache Heuristik oder eine skalierte Regression der richtige erste Schritt. Heuristiken sind schnell: „Wenn die Engagement-Velocity in Markt X Woche für Woche um 20 % fällt, verschiebe 15 Prozent der bezahlten Verstärkung dieses Markts zu den Top-3-Creatorn.“ Regression liefert ein saubereres Signal, wenn du historische Spend-, Impressions- und Outcome-Daten auf Kampagnenebene über Märkte und Creator-Tiers hinweg hast. Probabilistische oder Zeitreihenmodelle gehören dorthin, wo Daten reichlich und konsolidiert sind und Stakeholder eine wahrscheinlichkeitsbasierte Lesart akzeptieren statt eines Einzelpunkt-Forecasts.
Praktische Tradeoffs zählen mehr als theoretische Genauigkeit. Einfachere Modelle sind robust gegen fehlende Daten und leichter in einem Finance-Review zu erklären. Sie scheitern gnädig: Du bekommst eine falsche Zahl, kannst aber die Logik nachvollziehen. Regressionsmodelle bringen Nuancen und lassen dich Saisonalität, Creative-Typ und bezahlten Spend kontrollieren, brauchen aber konsistentes Labeling und jemanden im Team, der Outputs neu trainieren und auf Plausibilität prüfen kann. Fortgeschrittene probabilistische Modelle reduzieren Überraschungen, wenn du lange Verteilungen der Creator-Performance und mehrwöchige Abhängigkeiten hast, können aber auch falsches Selbstvertrauen erzeugen. Ein probabilistischer Forecast, der raffiniert aussieht, aber mit veralteten oder falsch zugeordneten Conversions gefüttert wird, beschleunigt nur schlechte Entscheidungen. Hier hilft die Wetter-Metapher: Eine ausgefeilte Forecast-Engine braucht präzise Datenwinde, sonst ist der Forecast nur Rauschen.
Checkliste, um die Modellwahl auf dein Team und deine Entscheidungsbedarfe abzustimmen:
- Datenreife: Konsolidierter Data Lake oder Single Source of Truth vorhanden? Wenn nein, starte mit Heuristiken.
- Team-Skills: Ein Analyst und ein PM heißt Regression ist okay; kein Analyst heißt Heuristiken plus automatisierte Signale.
- Entscheidungs-Kadenz: Tägliches Spend-Pacing braucht leichte Modelle; wöchentliche Budget-Umschichtung verträgt Regressionen oder einfache Zeitreihen.
- Akzeptable Fehlermarge: Wenn Finance +/- 5 Prozent verlangt, plane probabilistische Modelle und Governance ein.
- Governance- und Compliance-Risiko: Wenn Legal regelmäßig Creator pausiert, stelle sicher, dass das Modell Compliance-Signale aufnimmt, bevor du ein automatisiertes Pacing-Modell wählst.
Achte außerdem darauf, dass das Modell zur Entscheidungsbefugnis passt. Wenn Procurement oder Finance die Umschichtung kontrolliert, ist eine transparente Regression mit wenigen erklärbaren Features leichter zu verteidigen als eine Blackbox. Wenn der Social-Ops-Lead eine Live-Lesart braucht, um Creator zu pausieren oder zu pushen, willst du Modelle, die klare Signale und eine empfohlene Aktion liefern, nicht eine einzige undurchsichtige Metrik. Mydrop kann hier praktisch helfen: Creator-Metadaten zentralisieren, UTM- und Creator-Verknüpfung automatisieren und Modell-Inputs für Reviewer sichtbar machen, damit sich der Forecast prüfbar anfühlt und nicht mystisch.
Übersetz die Idee in den Alltag
Forecasts zählen nur, wenn sie ändern, was Menschen jeden Tag tun. Übersetze Modell-Outputs in drei operative Rituale: den Content-Kalender justieren, bezahlten Spend pacen und Creator-Roster auffrischen. Jedes Ritual braucht einen Owner, eine kleine Checkliste und ein Regelwerk, das an den Forecast gekoppelt ist. Zum Beispiel: Der tägliche Sensor-Lauf am Morgen (Marketing Ops) markiert jeden Creator, dessen Engagement-Velocity unter das 10. Perzentil des Modells fällt; der Content-Scheduler (lokaler Brand Manager) schiebt ein Backup-Creative in den nächsten Slot; der Paid-Media-Lead reduziert den Verstärkungs-Spend auf schwache Posts um den vom Modell empfohlenen Prozentsatz. Das sind konkrete Aktionen, keine Vorschläge. Das Modell ist die Forecast-Engine, die Sensoren sind Engagement-Velocity und UTM-verknüpfte Conversions, und das Team entscheidet anhand vorab vereinbarter Schwellen, ob es Schutz sucht oder weitermacht.
Mach Übergaben kurz und maschinell unterstützt. Verwandle Modell-Outputs in eine kompakte „Forecast Card“, die im geteilten Dashboard sichtbar ist: Markt, Creator, prognostizierte Lift-Range, Konfidenzband, empfohlene Aktion und erforderliche Freigabestufe. Ein einfaches Playbook funktioniert gut:
- Täglich: Sensor-Scan am Morgen (Marketing Ops) – bestätige, dass keine Compliance-Flags vorliegen, prüfe die Velocity, schicke die Forecast Card an lokale Brand und Paid Lead.
- Wöchentlich: Reallocation-Review (Brand Lead und Finance) – prüfe den aggregierten Forecast, genehmige Budget-Verschiebungen über der Schwelle.
- Ad hoc: Compliance-Pause-Flow (Legal und Social Ops) – wenn ein Creator pausiert wird, berechnet das Modell die Neuverteilung und benachrichtigt Paid Media für sofortiges Spend-Pacing. Mach das Playbook zum Teil der Team-Routine, damit der Forecast Verhalten prägt statt ein weiterer Report zu werden, den niemand liest.
Rechne mit Fehlermodi und bau kleine Guardrails ein. Häufige Probleme: verzögerte Conversion-Attribution, die einen False Negative für einen Creator erzeugt; eine Legal-Pause, die einen starken Creator mitten im Flug entfernt; oder uneinheitliches UTM-Tagging, das die Attribution bricht. Einfache Guardrails begrenzen den Schaden: Verlange ein 24-Stunden-Bestätigungsfenster, bevor mehr als X Prozent des Budgets zwischen Marken automatisch verschoben werden, deckle tägliche Auto-Spend-Änderungen auf ein kleines Band und setze ein Exception-Review für jede Umschichtung, die markenübergreifend gepoolte Budgets betrifft. Auch hier hilft die Wetter-Metapher: Lass ein automatisiertes System nicht den gesamten Spend verschieben, nur weil der Sensor durch einen Daten-Lag verzerrt war. Lass Automatisierung stattdessen Änderungen vorschlagen und überlasse Edge Cases einem leichten menschlichen Freigabeschritt.
Wer vor Ort was macht, ist entscheidend und wird oft unterschätzt. Social Ops sollte die Sensoren und Compliance-Inputs verantworten: Sie stellen sicher, dass Creator-Offenlegungsstatus und Vertragslimits ins Modell fließen. Marketing Ops oder ein Datenanalyst sollte die Forecast-Engine und ihre Retraining-Kadenz verantworten, plus ein Audit-Log der Modelländerungen. Paid Media oder Budget-Owner bekommen die Pacing-Empfehlungen und die finale Freigabe für Verschiebungen, die delegierte Schwellen überschreiten. Brand Manager übersetzen forecast-getriebene Roster-Wechsel in Kalenderänderungen und Creative-Anfragen. Diese Zuordnung verhindert, dass sich Arbeit bei Legal stapelt oder Reviewer unter Alerts begraben werden. Mydrop reduziert Reibung, indem Creator-Profile mit Vertrags- und Compliance-Feldern verknüpft werden, der Pause-Grund direkt auf der Forecast Card erscheint und die richtigen Freigabe-Workflows ausgelöst werden, sodass der richtige Mensch das richtige Signal zur richtigen Zeit sieht.
Zum Schluss: Automatisiere die Routine, aber nicht die Ausnahmen. Bau Trigger, die die Schwerarbeit machen: UTM-Parameter automatisch an Creator-Posts anhängen, diese UTMs zurück auf Creator-IDs mappen, Engagement-Velocity berechnen und mit dem Forecast vergleichen. Lass das System Aufgaben mit geringem Risiko auslösen, etwa ein Backup-Creative in den Kalender schieben oder bezahlte Verstärkung in einem kleinen Band reduzieren. Bei Entscheidungen mit höherem Risiko, etwa gepooltes Budget zwischen Marken verschieben oder vertragliche Zahlungsbedingungen ändern, behalte einen transparenten Human-in-the-Loop. Diese Kombination hält das Team beweglich und rechenschaftsfähig: Sensoren korrigieren Modelle im Flug, die Forecast-Engine aktualisiert Empfehlungen, und Menschen treffen die Urteile, auf die es ankommt.
Setz KI und Automatisierung dort ein, wo sie wirklich helfen
Der Campaign Weather Forecast funktioniert nur, wenn deine Sensoren smart sind und dein Autopilot strikte Guardrails hat. Klartext: KI nutzt du am besten zum Bereinigen, Verbinden und Alarmieren, nicht um am ersten Tag das Urteilsvermögen zu ersetzen. Starte mit drei praktischen Automatisierungszielen: Creator-IDs mit UTMs und Ad-Tags verknüpfen, Offenlegungs- oder Compliance-Anomalien für das Legal-Review sichtbar machen und leichte prädiktive Lifts laufen lassen, die den kurzfristigen Conversion-Upside für einen Creator schätzen, bevor du Spend umschichtest. Diese drei Automatisierungen verwandeln verstreute Datenwinde in eine nutzbare Brise für die Forecast-Engine. In der Praxis heißt das: Das Modell bekommt bessere Inputs in Echtzeit, und das Ops-Team bekommt ein lesbares Signal zum Handeln.
Hier eine kurze Liste praktischer Automatisierungen und Übergaben, die bei Enterprise-Teams wirklich Reibung abbauen:
- UTM-zu-Creator-Mapping: Creator-ID und Kampagnen-Metadaten automatisch an jedes Conversion-Event anhängen und dann eine tägliche Delta-Datei an Finance schicken.
- Compliance-Sensor: fehlende Offenlegungssprache oder bearbeitete Skripte markieren und sofort eine Aufgabe an den Legal-Reviewer routen, mit Belegen und Zeitstempeln.
- Pace-Predictor: ein 24-Stunden-Spend-Pacing-Forecast, der im geteilten Channel mit vorgeschlagenen Budget-Verschiebungen und einem Confidence Score gepostet wird.
- Creator-Swap-Vorschlag: wenn ein Top-Creator zwei Tage lang um X Prozent unterperformt, zwei Alternativen vorschlagen, sortiert nach jüngstem Lift und Reach-Overlap.
Diese Automatisierungen müssen klar positioniert und begrenzt sein. Ein Pace-Predictor kann zum Beispiel vorschlagen, dass Markt A 20 Prozent Unterspend in Markt B zieht, sollte aber niemals Geld ohne zweistufige Freigabe automatisch verschieben. Diesen Punkt unterschätzen die meisten: Vertrauen in ein automatisiertes System wächst, wenn es vorhersehbar und umkehrbar ist. Ein Experiment, das einen vorgeschlagenen Transfer an Finance automatisch sendet, auf eine schnelle menschliche Freigabe wartet und die Entscheidung dann im Kampagnen-Record loggt, liefert die Geschwindigkeit, die Teams brauchen, und hält Compliance und Procurement zufrieden.
Ein Mini-Workflow-Beispiel macht das konkret. Stell dir vor, die EU-Welle des CPG-Launches fällt an Tag 10 unter die erwartete Engagement-Velocity. Die Sensoren erkennen einen Rückgang der Engagement-Rate um 30 Prozent gegenüber dem Forecast, und der Compliance-Sensor meldet eine dreistündige Offenlegungslücke bei einem Top-Creator. Die Automatisierungs-Pipeline macht drei Dinge: 1) Sie erstellt einen konsolidierten Vorfall im Kampagnen-Workspace mit Daten und Zeitstempeln, 2) sie zeigt einen empfohlenen Umschichtungsbetrag mit prognostizierten Lift-Szenarien und angehängtem Konfidenzintervall, und 3) sie benachrichtigt die relevanten Approver in einem festgelegten Channel mit Ein-Klick-Annehmen oder -Ablehnen. Plattformen im Stil von Mydrop machen das gut, weil sie Assets, Freigaben und Reporting an derselben Stelle zentralisieren, an die die Sensoren schreiben. Das Modell korrigiert im Flug, die Forecast-Engine aktualisiert sich, und das Ops-Team kann mit Klarheit Schutz suchen oder weitermachen.
Rechne mit Fehlermodi und plane sie ein. Häufige Probleme sind Müll-Inputs – schlechte UTMs, doppelte Creator-Records und verzögerte Revenue-Events –, die die Vorhersagen verunreinigen. Eine weitere Falle ist Alert-Fatigue; Teams ignorieren die Sensoren, wenn alles rauscht. Justiere Schwellen nach Business-Bedarf, nicht danach, was das Modell produzieren kann. Und sei explizit beim Human-in-the-Loop: Wer zeichnet eine Budget-Verschiebung ab, wer genehmigt einen Creator-Swap, und wer verantwortet den Compliance-Vorfall. Automatisierungen sollten den Weg vom Signal zur Entscheidung verkürzen, nicht verbergen, wer verantwortlich ist.
Mess, was Fortschritt beweist
Wenn der Forecast die Wetterkarte ist, dann sind Metriken die Instrumente in deiner Tasche. Wähl ein Metrik-Set mit drei Ebenen und bleib dabei: Leading Signals, Attribution-Proxies und Business Outcomes. Leading Signals sind das, was du täglich beobachtest: Engagement-Velocity, View-to-Click-Momentum und die Posting-Kadenz der Creator. Attribution-Proxies sind die Near-Realtime-Messungen, die zeigen, dass eine Kampagne Nachfrage bewegt: promo-spezifische Landingpage-Conversions und Lift gegenüber gematchten nicht-exponierten Kohorten. Business Outcomes sind die ultimativen Checks: Revenue pro Creator, Repeat-Purchase-Lift und Bruttomargen-Effekt. Behalte die Ebenen, weil sie direkt auf Aktionen einzahlen: Sensoren für kurzfristige Kurskorrekturen, Proxies für taktische Umschichtungen und Outcomes für Quartals-Budgetentscheidungen.
So operationalisierst du Kadenz und Schwellen in einem echten Enterprise-Setting. Setz tägliche Checks für Leading Signals mit einer zweistufigen Eskalation: ein automatisierter Alert, wenn die Engagement-Velocity mehr als 20 Prozent unter dem Modell-Forecast liegt, und ein menschliches Review, wenn dasselbe Signal 48 Stunden anhält. Berechne Attribution-Proxies alle 48 Stunden mit rollierenden 7-Tage-Fenstern, um Momentum zu erwischen, ohne Rauschen hinterherzujagen. Reporte Business Outcomes wöchentlich an Finance und monatlich an den Executive Sponsor, mit vorab vereinbarten Fenstern für die Conversion-Attribution: 7 Tage für Low-Funnel-Promo-Aktionen, 30 Tage für typische Produktkäufe. Ein zweiwöchiger A/B-Pilot hilft, diese Schwellen vor dem breiten Rollout zu kalibrieren: Teile dasselbe Budget in zwei gematchte Kohorten, vergleiche die Proxy-Lifts und setz deine Akzeptanzkriterien anhand des inkrementellen ROAS, der Skalierung rechtfertigt.
Sei konkret dabei, was als Erfolg zählt. Für einen globalen CPG-Launch könnte ein vernünftiges frühes Ziel ein Lift von 15 Prozent bei den Promo-Landingpage-Conversions im Leitmarkt bis Woche drei sein, mit einem Revenue pro Post auf Creator-Ebene, das die fixen Talent-Fees bis Monat zwei deckt. Für einen Retailer, der mit festem Budget über fünf Marken umschichtet, ist Erfolg: weniger Bestands-Mismatches und 10 Prozent mehr Revenue pro Marke bei konstantem Gesamtspend. Agenturen, die inkrementellen Revenue beweisen wollen, starten mit einer Holdout-Gruppe und gematchten Kohorten; wenn die gemischten First- und Third-Party-Daten nur Attribution auf Proxy-Ebene stützen, nutze konsistente konservative Fenster und reporte die Unsicherheit bei jeder Zahl.
Achte auf Messfallen. Vanity-Metriken sind verführerisch: Viele Likes können Stakeholder in Sicherheit wiegen, sind aber schwache Prädiktoren für Kauf, solange du sie nicht an Velocity und Conversion-Proxies koppelst. Das Modell auf vergangene Creator-Gewinner zu überfitten ist ein häufiger Fehler; Creative-Trends ändern sich, also trainiere weiter auf aktuellen Fenstern und behandle ältere Wins als Kontext, nicht als Evangelium. Datenlatenz wird bei Revenue-Events immer ein Problem sein; löse das, indem du schnelle Proxies von langsamen Outcomes trennst und beide im selben Dashboard sichtbar machst, damit niemand eine verzögerte Revenue-Zahl als fehlende Intelligenz behandelt.
Ein paar praktische Regeln, die Teams helfen, Messung ehrlich und handlungsfähig zu halten:
- Veröffentliche ein geteiltes Dashboard pro Programm, das die Metriken der drei Ebenen, die Forecast-Linie und die aktuellen Sensor-Alerts enthält. Mach es zur Single Source of Truth für die täglichen Standups.
- Häng an jeden KPI ein Konfidenz-Label: niedrig, mittel, hoch. Und zeig, welche Datenwinde diese Konfidenz tragen. Wenn Conversion-Events verzögert oder gesampelt sind, sprich es an.
- Nutze kleine Holdouts und inkrementelles Testen: 5 bis 10 Prozent Kontrollgruppen sind günstig und stark, um Lift zu beweisen, und sie liefern bessere Signale an die Forecast-Engine.
Zum Schluss: Verankere die Messung in Entscheidungsritualen. Stell die Metriken der drei Ebenen an den Anfang der täglichen Ops-Standups und verlange eine explizite Entscheidungsregel: Wenn ein Leading Signal X Tage lang rot ist, schlägt die Forecast-Engine eine von drei Aktionen vor (Schutz suchen, mit Einschränkungen weitermachen oder umschichten), und ein benannter Approver muss aus diesen Optionen wählen. Feiere kleine Erfolge öffentlich; frühe, wiederholbare Verbesserungen beim Proxy-Lift bauen schneller Glaubwürdigkeit auf als perfekte Post-Campaign-Recall. Mit der Zeit verwandeln diese Messpraktiken Intuition in reproduzierbare Forecasts, und genau das ist der operative Vorteil, den Enterprise-Teams brauchen.
Verankere die Veränderung im ganzen Team
Change Management ist hier keine einmalige Schulung. Es sind kleine Rituale, die du so lange lebst, bis der Forecast zur Sprache des Teams wird. Fang damit an, Rollen und Übergaben zu benennen: Wer verantwortet die Forecast-Engine, wer liest morgens die Sensoren, wer hat die Befugnis, Geld zu verschieben, und wer triagiert Legal-Flags. Menschen hängen fest, wenn diese Linien unscharf sind. Finance wird zum Beispiel Umschichtungsbefugnis verlangen, sobald ein Markt unterperformt, während Legal darauf besteht, Creator bei einem Offenlegungsproblem zu pausieren. Bau klare Regeln, die Schwellen auf Aktionen abbilden, damit diese Gespräche offen und nach Zeitplan stattfinden, nicht in Slack-Threads um 23 Uhr.
Praktische Guardrails gewinnen Akzeptanz schneller als perfekte Modelle. Diesen Punkt unterschätzen die meisten: Teams versuchen oft, jede Entscheidung zu automatisieren, und geben dann dem Modell die Schuld, wenn die Ergebnisse wackeln. Starte stattdessen mit engen Human-in-the-Loop-Prozessen und erhöhe die Automatisierung, wenn das Vertrauen wächst. Nutze einen zweiwöchigen A/B-Pilot, der die Forecast-Engine gegen Live-Kampagnen in einem kontrollierten Ausschnitt laufen lässt: Eine Kohorte folgt dem modellgestützten Pacing und den Roster-Änderungen, die andere läuft wie gewohnt. Miss Forecast-Fehler, Entscheidungslatenz und Business Outcomes und iteriere dann. Halte während des Pilots ein Operations-Runbook bereit: wie man einen Creator pausiert, wie man eine Budgetlinie neu zuweist, wer grenzüberschreitenden Spend abzeichnet. Mydrop oder ähnliche Plattformen helfen hier, indem sie Assets, Freigaben und die täglichen Sensor-Werte zentralisieren, damit alle auf dieselben Zahlen schauen.
Nachhaltig wird es, wenn du den Forecast in Rituale einbettest, die Menschen ohnehin schon leben. Ersetz ein Ad-hoc-Statusmeeting durch einen 15-minütigen „Weather Check“, in dem die Schlagzeile der Forecast-Engine laut vorgelesen, die relevanten Sensoren markiert und eine konkrete Entscheidung getroffen wird. Mach Dashboards rollenspezifisch: Legal sieht Offenlegungs-Anomalien und Pause-Aktionen; Finance sieht Spend-Pacing und vorgeschlagene Umschichtungen; Brand Manager sehen Creative-Velocity und den Bestand an veröffentlichungsbereitem Content. Füg einfache Accountability-Metriken hinzu: Wie oft wurde eine forecast-angeordnete Aktion innerhalb der vereinbarten SLA umgesetzt, wie viele manuelle Overrides waren nötig, und wie viele Creator hatten Compliance-Holds, die innerhalb von 48 Stunden gelöst wurden. Feiere Erfolge laut: Wenn der Forecast verschwendeten Spend vermeidet oder Velocity in einem Markt zurückholt, sprich es an. Menschen übernehmen, worauf sie zeigen und wobei sie sich gut fühlen können.
- Fahre einen zweiwöchigen A/B-Pilot: Nimm eine Produktlinie, teile Märkte oder Marken auf, wende die Forecast-Regeln auf eine Kohorte an und behalte die andere als Kontrolle; tracke Forecast-Genauigkeit, Entscheidungs-Vorlaufzeit und Revenue-Delta.
- Leg eine dreistufige Metadaten-Taxonomie fest: Creator-ID, Kampagnen-Tag und UTM-Mapping. Setz sie in Brief-Templates durch und automatisiere den Join, damit die Sensoren den Forecast zuverlässig füttern.
- Schreib ein einseitiges Runbook für häufige Vorfälle: pausierte Creator, Offenlegungs-Flags, Budget-Umschichtung. Mit Entscheidungs-Ownern, SLAs und Rollback-Schritten.
Fazit
Das Schwierige an vorhersehbarem Influencer-ROI ist nicht die Mathematik. Es ist die organisatorische Verkabelung, die dafür sorgt, dass Signale von Creator-Tags und Legal-Checks in die Forecast-Engine fließen und dass Forecast-Outputs zu klaren, zeitgebundenen Entscheidungen werden. Behandle den Campaign Weather Forecast als operative Infrastruktur: Sensoren brauchen Wartung, das Modell braucht regelmäßige Kalibrierung, und Entscheidungsregeln müssen überprüft werden, wann immer das Business das Tempo ändert. Wenn diese Teile zusammenspielen, schrumpfen Überraschungen und das Vertrauen wächst: Teams können schneller handeln, ohne die Kontrolle abzugeben.
Starte klein, instrumentiere alles, was zählt, und mach Verantwortlichkeit sichtbar. Nutze Pilot-Fenster, um den Unterschied zwischen Raten und Prognostizieren zu zeigen, halte Menschen fest im Loop, während Automatisierungen Vertrauen verdienen, und backe die Rituale in tägliche Workflows ein, damit der Forecast zum Standard-Debattenstarter wird und nicht zum optionalen Report. Wenn du das tust, wirst du merken, wie sich die Gespräche verschieben: weg vom Verteidigen des Spend, hin zum Optimieren.


 Google-Bewertung
 Trustpilot-Bewertung
 Product Hunt comment





