
















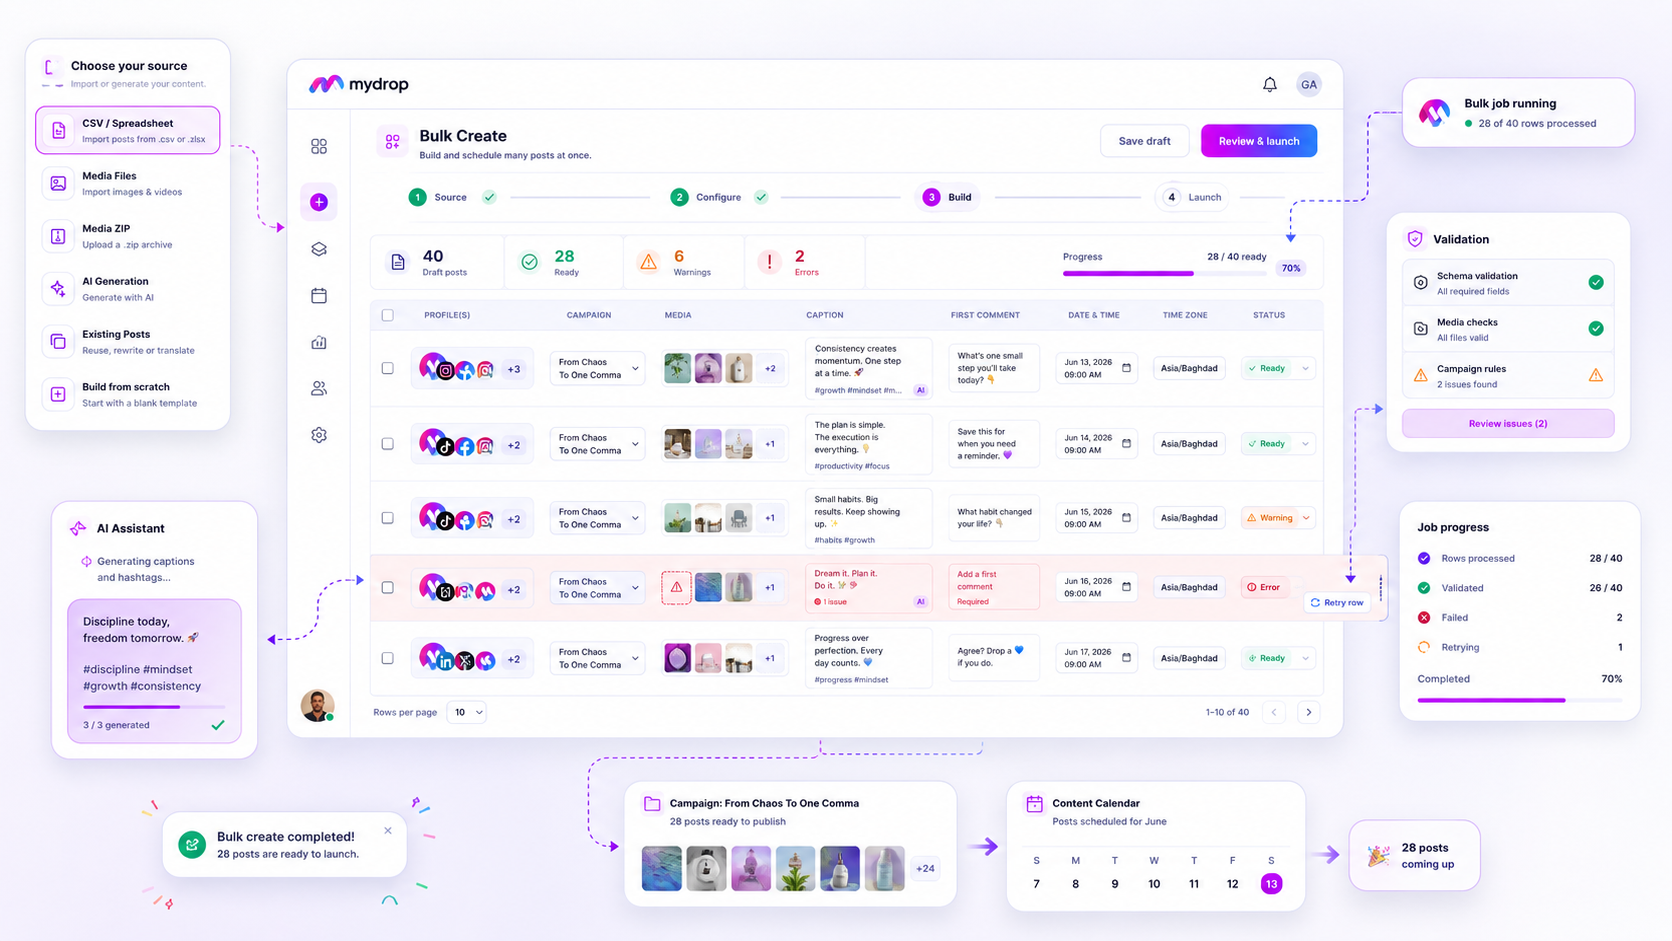
Smettila di costruire a mano il calendario della campagna. Quando il tuo piano di lancio supera i cinquanta asset, il composer standard smette di essere uno strumento creativo e diventa una trappola meccanica: il tuo team ripete le stesse configurazioni finché gli errori diventano inevitabili. Non stai sbagliando l'esecuzione; stai sbattendo contro un tetto invalicabile, dove l'input umano non riesce a tenere il passo delle esigenze della campagna.
Passare alla creazione massiva non significa solo andare più veloce. Significa sostituire passaggi manuali e fragili con un processo ripetibile e validato che blocca la tua governance prima che il primo post arrivi su una sola piattaforma.
Ti capiamo. Ti hanno detto che creare i post uno per uno, con cura artigianale, è l'unico modo per garantire qualità. Ma quando gestisci iniziative multi-brand o lanci su più mercati, quell'approccio porta spesso a versioni che non combaciano, tagging incoerente e una corsa frenetica per correggere link rotti all'ultimo minuto. L'obiettivo è spostare il tuo team dalla lotta agli incendi a un modello di campagna a catena di montaggio: definisci gli standard una volta e lascia che sia il sistema a fare il lavoro pesante.
La decisione che ogni metrica dovrebbe innescare
Capisci esattamente quando abbandonare il composer manuale guardando dove va la tua energia durante un lancio. Se il tuo team passa più tempo a inserire dati, ritoccare la formattazione e ricontrollare tre volte la compliance che a fare strategia vera, è ora di cambiare.
Usa questa matrice decisionale per capire qual è il tuo prossimo passo:
| Scenario | Attrito principale | Flusso di lavoro consigliato |
|---|---|---|
| Bassa complessità, basso volume | Attività di scheduling di base | Composer manuale dei post |
| Alta complessità, basso volume | Approvazioni personalizzate degli stakeholder | Composer dei post + template |
| Bassa complessità, alto volume | Inserimento dati ripetitivo | Bulk Create (CSV/Scratch) |
| Alta complessità, alto volume | Scalare gli asset creativi | Bulk Create + pacchetti AI/ZIP |
Regola dell'operatore: se una campagna richiede più di tre ore di inserimento dati manuale per un solo lancio, hai già superato il punto in cui la precisione umana può essere garantita.
Dati Mydrop, settembre 2026: nei 30 giorni fino al 16 settembre 2026, il 98,5% dei post pubblicati tramite Mydrop è andato online al primo tentativo. L'avviso più comune è stato il rifiuto di una miniatura personalizzata di YouTube perché il canale non era verificato tramite telefono; il fallimento definitivo più comune è stata una connessione alla piattaforma scaduta. Metodologia nei benchmark sui social media di Mydrop.
Quando il volume è alto, il tuo rischio più grande non è una scelta creativa sbagliata; è un fallimento dell'intero batch causato da una sola riga formattata male. In Mydrop vediamo team passare da fogli di calcolo sparsi e pieni di errori a job massivi centralizzati, perché vogliono vedere esattamente quali post superano la validazione e quali righe hanno bisogno di un ritocco veloce. È così che ti riprendi il tuo tempo, assicurandoti che i tuoi operatori più esperti spendano le energie sulla strategia di brand invece che a sistemare metadati rotti.
La scorecard che rende utile il reporting
Smettila di fissarti sulle vanity metric prima che la campagna abbia finito la prima settimana. Quando lanci un batch di cinquanta post, il reporting deve passare dal monitoraggio del singolo post al monitoraggio della salute del batch. Se passi tre ore ad aggregare a mano i dati di performance di ogni singolo asset di un job massivo, hai già perso i guadagni di efficienza per cui hai lottato durante il lancio.
Gli operatori migliori che vediamo usano una scorecard semplificata. Invece di controllare se il "Post #34" ha raggiunto il suo target esatto di like, guardano al segnale aggregato. Se usi Mydrop, l'interfaccia Bulk Jobs ti dà automaticamente quella vista d'insieme, mostrando quale percentuale della campagna è andata come previsto e dove restano i vuoti.
| Metrica | Perché conta | Quando scatta la decisione |
|---|---|---|
| Tasso di successo delle righe | Indica se i tuoi asset creativi o i testi avevano problemi di formato. | Se <95%, controlla il CSV o il set di media di partenza prima del prossimo job. |
| Latenza di pubblicazione | Misura se la timeline pianificata è stata rispettata senza ritardi della piattaforma. | Se la varianza è >30 min, controlla la configurazione del fuso orario o la connessione API. |
| Rapporto errori/azioni | Ti dice quanto tempo il team ha passato a correggere invece che a creare. | Se >1:5, passa dal composer manuale ai flussi di lavoro massivi automatizzati. |
| Errori di validazione | Evidenzia blocchi ricorrenti di governance o compliance. | Usali per aggiornare i tuoi default globali e i template. |
Usa questa scorecard per decidere se una campagna ha bisogno di una correzione di rotta o solo di un po' più di tempo. Se un job massivo mostra un tasso di successo del 90%, non far perdere tempo al tuo senior manager a caccia del 10% mancante. Lancia un retry mirato su quelle righe fallite e passa alla prossima riunione di strategia.
Cosa smettere di misurare per default
Devi tagliare senza pietà i dati che creano rumore senza aiutarti a decidere. La maggior parte dei team enterprise annega in "metriche di processo" che non cambiano davvero il modo in cui lavorano.
Smettere subito di tracciare queste tre cose:
- Il totale cumulativo dei like su tutti i post. È una metrica che fa sentire bene, ma non ti dice nulla su quale segmento della campagna ha davvero spostato l'ago.
- I tempi di login individuali nell'editor dei post. Se stai tracciando chi ha passato quanto tempo nel composer, stai gestendo fogli presenze, non impatto social. Se il lavoro è fatto, lascia stare.
- La durata dalla bozza alla pubblicazione per i contenuti minori. Se un post richiede quattro giorni di avanti e indietro per un aggiornamento di routine, il problema è il tuo processo di approvazione, non le persone.
L'obiettivo del passaggio alla produzione massiva automatizzata è liberare il tuo team per risolvere problemi creativi di alto livello, non microgestire l'interfaccia di scheduling. Se scopri che il tuo team passa ancora ore a verificare a mano i post dopo che sono passati da un motore massivo, dai un'occhiata alle tue soglie di approvazione.
Check decisionale: se il tuo team passa più di dieci minuti per ogni post creato in massa nella verifica post-lancio, le tue regole di validazione automatica sono troppo lasche o la fiducia nei dati di partenza è troppo bassa.
Quando ti fidi del tuo processo a batch, smetti di controllare la macchina e inizi a controllare i risultati. È il momento in cui il tuo reparto passa da un ufficio di trasmissione glorificato a una vera campagna a catena di montaggio.
Come collegare le metriche alle prossime azioni
La maggior parte delle dashboard sono cimiteri digitali dove dati perfettamente validi vanno a morire. Per far lavorare davvero i numeri per te, collega ogni trend che puoi riportare a una leva operativa specifica. Se vedi un calo di engagement in un job massivo, non fissare il grafico a linee; guarda lo stato a livello di riga.
Vediamo spesso team trattare le "righe fallite" come un problema astratto, ma in Mydrop le trattiamo come singole voci di lavoro. Quando un batch si inceppa, la tua prossima azione dovrebbe essere binaria: riprova le righe fallite specifiche oppure ritocca la fonte di input.
Ecco come collegare i segnali in uscita alla mossa giusta:
| Segnale osservato | Il "perché" | La tua prossima azione |
|---|---|---|
| Alto tasso di righe fallite | Mismatch di validazione o timeout degli asset | Controlla i log degli errori a livello di riga e aggiorna il CSV o il set di media di partenza. |
| Tono delle caption sempre fuori posto | La generazione AI ha bisogno di più contesto | Stringi i default della campagna nella prossima configurazione di Bulk Create. |
| Latenza di completamento del batch | Overhead di rete o limite API raggiunto | Aumenta il tempo di buffer o dividi i pacchetti ZIP grandi in batch più piccoli. |
| Volume di contenuti inatteso | Troppi job massivi attivi | Annulla e rimetti in coda per liberare il percorso, oppure usa il bulkJobId per identificare e ripulire i post orfani. |
Check del flusso di lavoro: non "sperare" mai che un batch fallito si sistemi da solo con un retry. Se una riga è fallita due volte, c'è un problema strutturale nel file di partenza. Correggi la fonte, poi premi retry.
La cadenza di revisione che fa durare il modello
Una campagna a catena di montaggio funziona fluida solo quanto il suo checkpoint finale. Se non revisioni la tua attività bulk-create come parte di un ritmo ricorrente, tornerai inevitabilmente al lavoro manuale e ad alto rischio.
Il segreto è separare la validazione tecnica dall'approvazione del brand. Il tuo team tecnico dovrebbe gestire la validazione a livello di riga (assicurandosi che link, tag e conteggio caratteri siano puliti), mentre i responsabili del brand gestiscono l'aspetto creativo.
Segui questa cadenza di revisione in tre passaggi per mantenere il sistema pulito:
- Il pre-flight (settimanale): controlla lo stato dei job massivi per tutti i lanci in arrivo. Se un job è ancora in stato
queuedopending48 ore prima della data target, indaga sul collo di bottiglia. - L'audit post-batch (in tempo reale): quando un job
Bulk Createfinisce, dai un'occhiata al riepilogo di completamento. Ogni riga è passata? Se no, gestisci subito quelle voci invece di lasciarle accumulare. - La "pulizia di casa" (mensile): cerca per
bulkJobIdper identificare bozze rimaste in sospeso o esperimenti andati male. Usa la capacità di pulizia massiva di Mydrop per eliminare questi asset vecchi: così il tuo calendario non diventa uno spazio di lavoro disordinato e difficile da navigare.
Conclusione
Passare dalla composizione manuale a un motore su scala campagna raramente riguarda la tecnologia in sé. Riguarda l'ammettere che il tuo processo attuale ha un tetto. Quando passi a un flusso di lavoro automatizzato, non stai solo risparmiando tempo; stai spostando l'energia del tuo team dal "copia-incollare testo" al "governare la strategia".
Smettila di combattere con l'orologio ogni volta che lanci un prodotto o fai un blitz stagionale. Usando i job massivi per gestire il lavoro pesante, costruisci un'abitudine operativa che scala. Mantieni il controllo creativo che conta e ti liberi degli errori meccanici che non contano. Alla fine della giornata, il tuo brand merita una pipeline di consegna professionale e prevedibile, e il tuo team merita una settimana che non finisce in una corsa frenetica e manuale.



 Recensione Google
 Recensione Trustpilot
 Product Hunt comment





